KDE slaví 30 let. Přesně před 30 lety, 14. října 1996, poslal Matthias Ettrich do diskusní skupiny comp.os.linux.misc zprávu, která započala historii projektu KDE. Důležité milníky jsou zobrazeny na časové ose.
Byl vydán Mozilla Firefox 158.0. Stejně jako Chrome 155 s podporou JPEG XL (test). Přehled novinek v poznámkách k vydání a poznámkách k vydání pro vývojáře. Řešeny jsou rovněž bezpečnostní chyby. Nový Firefox 158 bude brzy k dispozici také na Flathubu a Snapcraftu.
Svobodný kancelářský balík ONLYOFFICE (Wikipedie) byl vydán ve verzi 10.0. Jak online Docs, tak i offline Desktop Editors. Přehled novinek také na YouTube.
Mozilla představuje Firefox Enterprise určený jako podnikový prohlížeč pro organizace s přísnými požadavky na bezpečnost, správu a dodržování předpisů. S profesionální podporou. Dostupný je zatím ve Francii, Německu, Rakousku a Švýcarsku.
Kybernetický útok zasáhl nejméně 150 supermarketů Intermarché a několik prodejen řetězců Leclerc a Coopérative U. Chladicí jednotky napadených obchodních domů byly nastaveny na nepřetržité odmrazování a teplota v nich mnohdy vystouala až nad 50°C. Škody napáchané na chlazeném a mraženém zboží budou patrně dosahovat miliónů eur.
… více »Stát Kalifornie zažaloval výrobce 3D tiskových filamentů Polymaker. Vrchní soud San Diego County tvrdí, že firma propagací svých výrobků mezi příznivci 3D tištěných zbraní podporovala výrobu takzvaných 'ghost guns' (DIY zbraní) a že její PLA filament pro 3D tiskárny lze za těchto okolností považovat za součást určenou k výrobě střelné zbraně. Žaloba požaduje mimo jiné finanční sankce a soudní zákaz činnosti, Polymaker se hájí tím, že filament je běžný a sám o sobě legální produkt. Celý text žaloby (PDF na Google Drive).
V červnu byla představena aplikace Myna pro převod řeči na text v prostředí desktopu Ubuntu. Včera byla Myna zpřístupněna širší komunitě Ubuntu formou technologické ukázky dostupné v Ubuntu 24.04 LTS, Ubuntu 26.04 LTS a Ubuntu 26.10 s GNOME na Waylandu.
Ubuntu 27.04 bude Tenacious T-Rex.
Byla vydána nová verze 2026.4.0 "Never-slop" svobodného softwaru ScummVM (Wikipedie) umožňujícího bezproblémový běh mnoha klasických adventur na zařízeních, pro které nebyly nikdy určeny. Přehled novinek v poznámkách k vydání a na GitHubu. ScummVM oslavil 25 let. Verze 0.0.1 vyšla 8. října 2001.
Kanadský vývojář Anthony Sistilli vytvořil ironický DIY projekt parodující kamerové systémy Flock, s cílem názorně demonstrovat rizika masového sledování jaké provozují tyto komerční ALPR systémy. Z levné IP kamery a vlastního ML softwaru (napsaného s pomocí SI circa za 20 minut, kód se mi bohužel nepodařilo dohledat) běžícího v laptopu sestavil jednoduchý systém, který detekuje výhradně policejní vozidla, zaznamenává jejich SPZ a
… více » 30.1.2017 19:08
Josef Kufner | skóre: 70
\|&* vedle levého shiftu na mém Thinkpadu. Dokonce je to v KDE v nastavení klávesnice snadno nastavitelné  30.1.2017 19:33
Josef Kufner | skóre: 70
man xcompose
30.1.2017 19:36
Josef Kufner | skóre: 70
/usr/share/X11/locale/*/Compose.
 30.1.2017 20:58
Bystroushaak | skóre: 36
| blog: Bystroushaakův blog
| Praha
Díky, konečně mám využití pro klávesuJá jí třeba používám takhle:\|&*vedle levého shiftu na mém Thinkpadu. Dokonce je to v KDE v nastavení klávesnice snadno nastavitelné
! troll klavesa
keycode 94 = U201E U201C 1 1 U201A U2018
Tedy na psaní „“‚‘
 2.2.2017 01:09
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
3.2.2017 14:15
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
 31.1.2017 11:51
⧠ A = 0 | skóre: 11
| blog: Technokratovo_zrcadlo
| 上海
1.2.2017 06:42
⧠ A = 0 | skóre: 11
| blog: Technokratovo_zrcadlo
| 上海
 1.2.2017 07:38
ʚĭɞ 🍉 | skóre: 94
| blog:
31.1.2017 11:56
⧠ A = 0 | skóre: 11
| blog: Technokratovo_zrcadlo
| 上海
(mimochodem věděli jste, že slovenská abeceda je ze všech nejrozsáhlejší?).Těžko.
všechny abecedy založené na latinceU fonetické abecedy bych si netroufnul tvrdit, že je založená na latince ("založená" chápu minimálně jako výraznou podobnost syntaxe, sémantiky, vizuální reprezentace). Fonetická abeceda toto nemůže splnit, protože diverzita řečí nezaložených na latince je výrazně vyšší než řečí založených na latince a tudíž fonetická abeceda zachycuje především výslovnost řečí nezaložených na latince. Příště raději upřesním, že se jedná o národní abecedy (nikoliv mezinárodní).
1.2.2017 09:24
⧠ A = 0 | skóre: 11
| blog: Technokratovo_zrcadlo
| 上海
Viz.Asi nemám moc představu, co znamenají pojmy syntaxe a sémantiky v případě abecedy, kromě toho, že se dá psát zprava doleva, shora dolů atp. či třeba v blocích – v tomto smyslu fonetická abeceda funguje úplně stejně jako latinka (píše se zprava doleva, řádky se řadí shora dolů). Co se týče visuální representace, podoba drtivé většiny znaků je založena na latince, několik málo znaků vychází z řeckého písma (ɛ, ɜ, ɸ, β, θ) a u ještě menšího počtu znaků na první pohled těžko říci ( ɣ, ɰ).všechny abecedy založené na latinceU fonetické abecedy bych si netroufnul tvrdit, že je založená na latince ("založená" chápu minimálně jako výraznou podobnost syntaxe, sémantiky, vizuální reprezentace).
Fonetická abeceda toto nemůže splnit, protože diverzita řečí nezaložených na latince je výrazně vyšší než řečí založených na latince a tudíž fonetická abeceda zachycuje především výslovnost řečí nezaložených na latince.To jsou z mnoha pohledů dost pochybná tvrzení.
…je to výrazně jednodušší a rychlejší než to co popisuje autor v článku.Nejsem si jist. Unikly vám přinejmenším dva fakty: 1, Nemám potřebu psát ty znaky neustále, pouze občas. 2, Nechci žádný extra soft, extra klávesnicový layout, ani žádnou speciální úpravu výchozího nastavení. To co popisuji má k dispozici každý uživatel, který si nainstaluje standardní Debian s českým prostředím. Jediný uživatelský zásah je max. to, že si přemapuje některou z kláves aby fungovala jako Multi_key – pokud to potřebuje.
Unikly vám přinejmenším dva fakty: 1, Nemám potřebu psát ty znaky neustále, pouze občas.Nezáleží jak často. Záleží jak komfortně (v článku popisujete, že kvůli komfortu jste přestal kopírovat znaky z gucharmap).
Pokud však narážíte na přepínání layoutů, tak stačí spočítat množství stisků jednotlivých kláves a přepínání layoutů vyjde výrazně lépe než metody popsané v článku. Pochopitelně malé množství stisků kláves není ekvivalentní úplné metrice komfortu, avšak je v tomto případě zdaleka nejvýraznějším faktorem.
2, Nechci žádný extra soft, extra klávesnicový layout, ani žádnou speciální úpravu výchozího nastavení. To co popisuji má k dispozici každý uživatel, který si nainstaluje standardní Debian s českým prostředím. Jediný uživatelský zásah je max. to, že si přemapuje některou z kláves aby fungovala jako Multi_key – pokud to potřebuje.Chápu a souhlasím. V článku jsem však tuto intenci nenalezl, a proto jsem si dovolil zmínit ULKL.
Multi_key, ale dead_caron, dead_tilde či další „mrtvé” klávesy. Ani s pomocí xev se mi je však nedaří na mé klávesnici identifikovat. Poradíte?
1.2.2017 11:45
ʚĭɞ 🍉 | skóre: 94
| blog:
Ale zároveň to byla pro mne příležitost na jednom místě souhrně uvést co je a není pomlčka.
Hmm. Dosud mi přišlo snazší se prostě odkázat na UJČ, vraždu (strana 25 v PDF), potažmo v případě vysvětlování rozložení na klávesnici na Wikipedii (a v případě psaní unikódu konkrétně na článek Unicode input).
 2.2.2017 21:57
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
Bylo by zajímavé doplnit slovníky českými názvy znaků, přepnout vstupní metodu, napsat české jméno požadovaného znaku, potvrdit a pokračovat v psaní. Rozhodně lepší než tohle harakiri a potřeby pamatovat si jakési klávesové komba.
2.2.2017 21:59
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
2.2.2017 22:16
ʚĭɞ 🍉 | skóre: 94
| blog:
2.2.2017 22:26
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
2.2.2017 22:47
ʚĭɞ 🍉 | skóre: 94
| blog:
3.2.2017 14:43
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
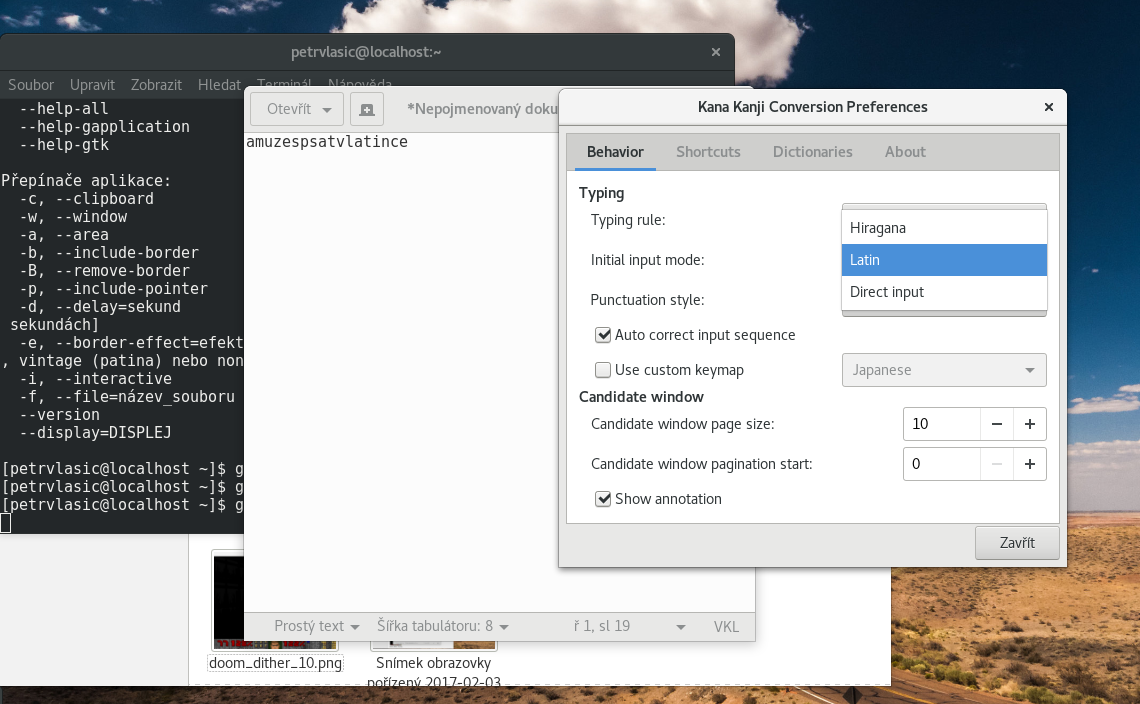
Je to na pytel, protože potřebuješ vizuální kontrolu.Nezapomeň že kana je pro ně to stejné co pro nás latinka. Oni tu vizuální kontrolu mají. Nepředpokládám že by to tam drtili v rōmaji jako my. Ale jinak si to přepni na latinku (viz screenshot) a můžeš v ní jednotlivé segmenty psát, nebude ti to převádět do kany.
Konečně, u češtiny narazíš na flexi, což u kandži/chan-c' vlastně neexistuje.Nepředpokládal jsem samozřejmě o použití téhle vstupní metody pro celou češtinu či angličtinu. Pouze ty sázecí znaky (jeden znak = jeden unicode a je šumák jestli je to kandži nebo sázecí znak, jméno musí mít tak jako tak). To by byla spíš morzeovka než rozumné psaní když by si to tam frkal v segmentech, doplňoval mezerníkem a ještě potvrzoval. Navíc jak říkáš, to může rozumně fungovat pouze u logogramů (když už nic, snadno se vizuálně hledají v seznamu). Navíc bych nic takového nechěl, sám vidíš co mi dělá auto korekce s textem, když by to ještě automaticky doplňovalo, tak už by se to po mě nedalo přečíst vůbec (nejsem pozorný).
3.2.2017 14:55
ʚĭɞ 🍉 | skóre: 94
| blog:
Oni tu vizuální kontrolu mají.Nutnost vizuální kontroly je při psaní kontraproduktivní.
Nepředpokládám že by to tam drtili v rōmaji jako my.Třeba Číňani dneska velmi často (možná i většinou) píšou pchin-jin, místo aby šli po radikálech.
3.2.2017 15:01
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
Počkat, já přestávám rozumět, oč ti vlastně jde.Nejde mi o automatickou expanzi psaného textu, pouze o vyhledávání sázecích znaků vypsáním jejich jména (takhle funguje anthy, nakonec cokoliv napíšeš převede na znak či znaky i když ne sázecí ale čínské logogramy). Různé komba či hexakódy se pro různé znaky špatně pamatují, se jménem (i když by to mělo být anglické jméno) už je to lepší.
3.2.2017 15:42
ʚĭɞ 🍉 | skóre: 94
| blog:
shrugs<klapka> pro expanzi na ¯\_(ツ)_/¯.
3.2.2017 19:24
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
3.2.2017 19:25
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
3.2.2017 08:53
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
3.2.2017 14:44
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
Tiskni
Sdílej:


 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz