Zranitelnost v aktualizačním mechanismu WordPress umožňuje útočníkovi zasáhnout do dočasného instalačního adresáře během aktualizace jádra systému. Před aktualizací veřejně dostupného WordPressu dočasně zablokovat HTTP přístup k wp-content/upgrade/, následně aktualizovat a zkontrolovat logy. Postižené verze: WordPress 4.7 až 7.1.3.
Alpine Linux zveřejnil podrobnosti o útoku na svůj GitLab a 30. října oznámil obnovení provozu. Útočník se 20.–21. října pokusil zneužít chybu v regulárních výrazech. Exploit způsobil opakované pády workerů a několikrát se dostal do pokročilé fáze. Úspěšné spuštění kódu však nebylo potvrzeno. Fix: Opravený GitLab a současně Ruby 3.3.13, 3.4.12 nebo 4.0.9+, pokud jde o vlastní sestavení či kontejner.
Konference OpenAlt 2026 proběhne tento víkend 7. a 8. listopadu na FIT VUT v Brně. Jedná se již o 21. ročník této konference, která propojuje otevřené technologie, svobodný software, hardware a lidi, kteří chtějí věci nejen používat, ale také jim rozumět a měnit je k lepšímu. Více o konferenci v příspěvku OpenAlt 2026: technologie, které dávají svobodu na blogu spolku OpenAlt.
Eben Upton oznámil další zdražení jednodeskových počítačů Raspberry Pi. Tentokrát 16 GB varianty Raspberry Pi o 80 dolarů a 16 GB varianty Raspberry Pi Compute Module 5 o 40 dolarů. Cena Raspberry Pi 500+ se nemění.
Francouzské Národní shromáždění přijalo 30. října 2026 poměrem 11 hlasů pro, 10 proti a 14 abstencí pozměňovací návrh I-1358 ke státnímu rozpočtu na rok 2027, který zavádí daň z objemu dat doručovaných uživatelům internetu. Návrh socialistického poslance Laurenta Lhardita stanovuje sazbu 0,055 eura za gigabajt, tedy 55 eur za terabajt. Zatím nejde o platný zákon, ale o dílčí hlasování během prvního čtení rozpočtu. Daň by měli platit
… více »Nizozemská vláda ve snaze šetřit a zvyšovat efektivitu s využitím umělé inteligence (AI) hodlá zrušit asi 25.000 pracovních míst ve státní správě. Cílem je postupně dosáhnout ročních úspor až 3,5 miliardy eur (85,2 miliardy Kč). Na konci loňského roku ve státní správě pracovalo rekordních 160.000 lidí. „Nemůžeme pokračovat v tom, co jsme dělali dosud,“ uvedl státní tajemník pro efektivní fungování vlády Eric van den Burg. „Proto
… více »Příspěvek na blogu PRUSA 3D představuje fotoaparát CAIM1 (Counter Artificial Intelligence Machine 1). Uměle vytvořený obsah je každým dnem těžší rozeznat od skutečných záběrů či fotografií, což podrývá důvěryhodnost žurnalistiky, archivních materiálů i každodenní tvorby obsahu. Fotoaparát CAIM1 byl vyvinut právě k tomu, aby ověřoval původ fotografií a videí přímo během jejich pořizování. Uvnitř fotoaparátu se nachází hardwarová Web3 peněženka se zabezpečovacím čipem Tropic Square TROPIC01.
Jonathan Thomas oznámil vydání nové verze 4.1 video editoru OpenShot (Wikipedie). Zdrojové kódy OpenShotu jsou k dispozici na GitHubu. Ke stažení je i balíček ve formátu AppImage. Stačí jej stáhnout, nastavit právo na spouštění a spustit.
from videocr import get_subtitles

if __name__ == '__main__':  # This check is mandatory for Windows.
    print(get_subtitles('video.mp4', lang='chi_sim+eng', sim_threshold=70, conf_threshold=65))
Přijde mi trochu ujeté že ten název souboru a jazyk, v tom musí být natvrdo zadrátovaní. Takto když to spustím vyhodí to pochopitelně error že "video.mp4" neexistuje. Bylo potřeba to upravit nafrom videocr import get_subtitles
if __name__ == '__main__': # This check is mandatory for Windows.
print(get_subtitles('/tmp/video', lang='slk+eng', sim_threshold=70, conf_threshold=65))
Kde soubor /tmp/video je symlink na soubor s filmem a jazyk titulků je slovenský, proto slk+eng.
Když se to pustí tak CPU jede naplno a v tempu to vytváří soubory jako například:
/tmp/tess_w45fo6y7
/tmp/tess_w45fo6y7.PNG
/tmp/tess_w45fo6y7.tsv
/tmp/tess_2dz6zzki
/tmp/tess_2dz6zzki.PNG
/tmp/tess_2dz6zzki.tsv
Takže se asi něco děje, ale bohužel ten program nedává žádný výstup ani po hodině. Není tu nějaký pythonista co by pomohl? Nebo neexistuje nějaký jinačí způsob jak vygrabovat z takto zmršeného hardsubed filmu obyčejné srt textové titulky?
Řešení dotazu:
 18.8.2020 21:41
Jendа | skóre: 78
| blog: Jenda
| JO70FB
import sys; get_subtitles(sys.argv[1], lang=sys.argv[2])
2) ten zdroják není dlouhý, to bys mohl zvládnout oddebugovat… Pro začátek bych si přidal debug print do funkce _image_to_data.
pip install videocra snažím se to spustit jako:
python example.py
from videocr import get_subtitles

save_subtitles_to_file('video.mp4', file_path='subtitle.srt', lang='slk', time_start='0:00', time_end='')
Podivej se do ~/tessdata zda se stahnula slovenstina..
python example.py
Traceback (most recent call last):
  File "example.py", line 3, in module
    save_subtitles_to_file('video.mp4', file_path='subtitle.srt', lang='slk', time_start='0:00', time_end='')
NameError: name 'save_subtitles_to_file' is not defined
Zkoušel jsem "video.mp4" nahradit "/tmp/video", ale chyba je stejná.
Nevím jestli to chápu dobře ale to save_subtitles_to_file je funkce ta by se potom ale měla nějak zavolat ne? A v těch kulatých závorkách se velice nic neděje, akorát se tam definujou proměnné?
A soubor ~/tessdata/slk.traineddata tu je. Má asi 14MB.
.tsv, což je nějaký kontejner s videem, který má v sobě titulky.
Jelikož je to jeden soubor, domníváš se, že jsou natvrdo vypálené v obraze. Ale tak to není! Natvrdo to měly některá starší videa. Tohle bylo evidentně ripnuté z nějakého DVD (napovídá tomu suffix – přípona). Proto musíš v prvé řadě zjistit co to je. A možností je několik:
ffprobe -i cesta/k/souboru_videanebo můžeš použít nejprve příkaz:
file -s cesta/k/souboru…který ti vykecá co to je. Taky bys měl vědět, že nejsou titulky jako titulky. V kontejneru mohou být titulky buď jako TEXT, nebo jako OBRÁZKY. Pokud jsou uloženy jako obrázky, je třeba stopu s titulkama vyexportovat (soubory
.sub a .idx) a teprve na tyto vyexportované soubory lze použít utilitu vobsub2srt, která ty obrázky postupně kuchá, dělá OCR a výsledek zapisuje do .srt souboru.
vyexportovat jako PNG obrázkyTo se mi nezdá, že by v 21. století se to muselo dělat takto manuálně. Videocr má v popisu napsáno "Extract hardcoded (burned-in) subtitles" a pokud by videocr nefungoval, tak fakt není žádný jiný OCR, který to umí automaticky bez nějakého exportování PNG?
… fakt není žádný jiný OCR, který to umí automaticky bez nějakého exportování PNG?KAŽDÝ to exportuje do PNG, jenom se ty soubory průběžně při zpracování zahazují. Takže je docela dobře možné, že videocr má v sobě zadrátované přesně to co jsem popsal. Tj. že vytahuje z původního snímku jen to co je bílé do nového, na který pak pustí OCR engine.
A ten videocr se spouští pythoním skriptem který si musí sám uživatel nějak dodělat. A to bohužel vůbec nedávám.
$ file -s /mnt/disk2/temp/video.avi
/mnt/disk2/temp/video.avi: RIFF (little-endian) data, AVI, 1280 x 720, >30 fps, video:, audio: (stereo, 44100 Hz)

$ ffprobe -i /mnt/disk2/temp/video.avi
Input #0, avi, from '/mnt/disk2/temp/video.avi':
  Metadata:
    encoder         : Lavf58.45.100
  Duration: 01:08:28.10, start: 0.000000, bitrate: 1428 kb/s
    Stream #0:0: Video: h264 (High) (avc1 / 0x31637661), yuv420p(progressive), 1280x720 [SAR 1:1 DAR 16:9], 1282 kb/s, 48 fps, 24 tbr, 48 tbn, 48 tbc
    Stream #0:1: Audio: aac (LC) ([255][0][0][0] / 0x00FF), 44100 Hz, stereo, fltp, 128 kb/s
$ tesseract /tmp/ss2.png stdout -l slk
Warning: Invalid resolution 0 dpi. Using 70 instead.
Estimating resolution as 481


F 'rĺ"d/
isom.sa jej všetko
a pĺqg%čo ÉAČT eh

k
tu bude asi zakopaný pes.
$ convert /tmp/ss2.png -threshold 90% - | tesseract stdin stdout -l slk
Warning: Invalid resolution 0 dpi. Using 70 instead.
zkoušel jsem různě měnit --dpi ale bez úspěchu.
$ convert /tmp/ss2.png -threshold 90% -channel RGB -negate - | tesseract stdin stdout -l slk
Warning: Invalid resolution 0 dpi. Using 70 instead.
Estimating resolution as 362
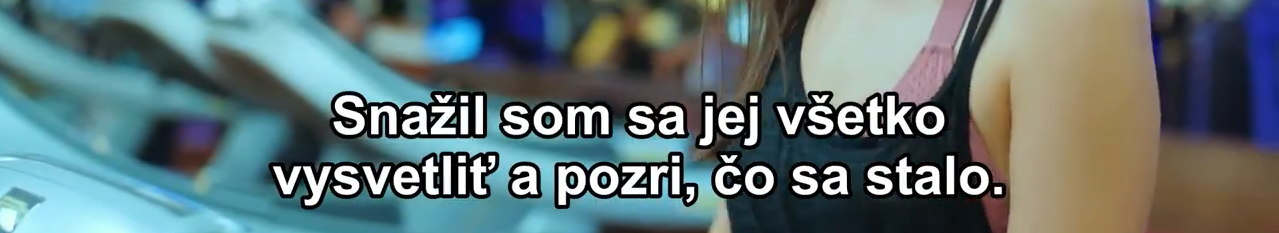
Snažil som sa jej všetko
vysvetliť a pozri, čo sa stalo.
takže tesseract funguje! Ale je to docela magie a nevím jestli s tím ten program videocr počítá.
 . Ten výstup se musí nějak přeparsovat. Občas je tam bordýlek. Zatím jsem nevymyslel jak na to. Taky jsem zjistil, že tesseract má docela potíže číst světlé písmo na tmavém pozadí. Proto se mu ty barvy musí převrátit. S bílýma titulkama je to v pohodě, se žlutýma už je to horší. Docela fajn vychytávka je ustřihnout pryč vrchní polovinu obrazu, tesseract se potom nesnaží číst loga televizních stanic a hodně se mu to čtení zlepší.
#!/bin/bash
video="$1"
jazyk=ces
if not [ -s "$1" ]; then exit 1; fi
delka=$(ffprobe -i "$video" -v error -select_streams v:0 \
    -show_entries stream=duration -of default=noprint_wrappers=1:nokey=1 | \
    cut -d. -f1)

pocitadlo() {
hh=$(echo "$f/3600" | bc)
mm=$(echo "($f-$hh*3600)/60" | bc)
ss=$(echo "$f-$hh*3600-$mm*60" | bc)
if [ $hh -lt 10 ]; then hh=0$hh; fi
if [ $mm -lt 10 ]; then mm=0$mm; fi
if [ $ss -lt 10 ]; then ss=0$ss; fi
cas="$hh:$mm:$ss"
}

f=0
while [ $f -lt $delka ]; do
pocitadlo
f=$((f+1))
#echo $cas
titulek=$(ffmpeg -ss $cas -i "$video" -an -sn -vf "crop=iw:ih/2:0:ih" \
       -vframes 1 -f image2pipe - 2> /dev/null |
       convert - -threshold 90% -channel RGB -negate - |
       tesseract stdin stdout -l $jazyk 2> /dev/null |
       grep [[:graph:]])
if [ -n "$titulek" ]; then printf "%s\n%s\n\n" "$cas" "$titulek"; fi
done
20.8.2020 13:14
Jendа | skóre: 78
| blog: Jenda
| JO70FB
convert -level 5,50%, to udělá ze všeho nad polovinu intenzity bílou.
. Problém je v tom, že vycuclé písmo je kostrbaté a OCR má problém s rozpoznáváním jednotlivých znaků. Zkoušel jsem měnit různě nastavení, ale bez valného výsledku. ABBYY FineReader, který by v tom asi měl být lepší se mi ve Wine rozjet nepodařilo a do VM se mi to instalovat nechtělo. Takže pokud nemáš odpor k win programům ve Wine nebo VM, tak můžeš zkoušet další prográmky z toho odkazu výše.
Otázka je jestli se jejdovi s videocr a tesseracte podaří dosáhnout lepšího výsledku aniž by musel každé 5. slovo opravovat.
20.8.2020 19:44
Jendа | skóre: 78
| blog: Jenda
| JO70FB
convert 245077-ss3-7829814832695538012.png -fuzz 15% -fill white -opaque "#edd341" out.png(nalezeno zadáním imagemagick convert replace color do gůglu), druhá je to udělat na černobílém obrázku
convert 245077-ss3-7829814832695538012.png -grayscale Rec709Luminance -level 5,50% out.png
Tiskni
Sdílej:


 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz