Nizozemská vláda ve snaze šetřit a zvyšovat efektivitu s využitím umělé inteligence (AI) hodlá zrušit asi 25.000 pracovních míst ve státní správě. Cílem je postupně dosáhnout ročních úspor až 3,5 miliardy eur (85,2 miliardy Kč). Na konci loňského roku ve státní správě pracovalo rekordních 160.000 lidí. „Nemůžeme pokračovat v tom, co jsme dělali dosud,“ uvedl státní tajemník pro efektivní fungování vlády Eric van den Burg. „Proto
… více »Příspěvek na blogu PRUSA 3D představuje fotoaparát CAIM1 (Counter Artificial Intelligence Machine 1). Uměle vytvořený obsah je každým dnem těžší rozeznat od skutečných záběrů či fotografií, což podrývá důvěryhodnost žurnalistiky, archivních materiálů i každodenní tvorby obsahu. Fotoaparát CAIM1 byl vyvinut právě k tomu, aby ověřoval původ fotografií a videí přímo během jejich pořizování. Uvnitř fotoaparátu se nachází hardwarová Web3 peněženka se zabezpečovacím čipem Tropic Square TROPIC01.
Jonathan Thomas oznámil vydání nové verze 4.1 video editoru OpenShot (Wikipedie). Zdrojové kódy OpenShotu jsou k dispozici na GitHubu. Ke stažení je i balíček ve formátu AppImage. Stačí jej stáhnout, nastavit právo na spouštění a spustit.
Při běžné migraci virtuálního stroje mezi hypervizory se jeho MAC adresa přesune na jiný leaf switch. EVPN tuto změnu distribuuje pomocí BGP Type-2 route a MAC mobility sequence number. Problém nastává, pokud útočník podvrhne zdrojovou MAC adresu jiného zařízení. Leaf může změnu interpretovat jako legitimní přesun MAC a rozšířit ji přes BGP do celé fabric. Výsledkem může být přesměrování provozu určeného původnímu zařízení. Autor článku rozebírá možnosti detekce pomocí sledování MAC moves, BGP route reflektorů a kontroly na přístupové vrstvě.
Vývojáři desktopového prostředí Enlightenment (Wikipedie) a souvisejících knihoven Enlightenment Foundation Libraries (EFL) vydali nové verze. Enlightenment byl vydán ve verzi 0.28.0 a Enlightenment Foundation Libraries ve verzi 1.29.
Cloudflare zjistil, že některé odpovědi modelu GLM-5.3 obsahovaly části dat z předchozích požadavků jiných zákazníků. Příčinou byla kombinace chybné konfigurace a chyby v inference enginu SGLang. Model podporoval kontextové okno 1 048 576 tokenů, ale GPU KV cache pool měl kapacitu pouze 681 280 tokenů. Při překročení kapacity docházelo k nesprávnému zpracování odmítnutého požadavku. Decode část systému následně pracovala se starými
… více »Vývojáři Knot Resolver vysvětlují, jak změnili rozhodování o tom, které DNS záznamy ponechat v cache a které odstranit. Článek obsahuje skutečná měření: devět hodin DNS provozu při 2 000 QPS, srovnání cache o velikosti 25 MB a 40 GB a také porovnání s BIND 9, kromě algoritmů obsahuje konkrétní doporučení pro konfiguraci a diagnostiku.
Největší kryptoměnová burza světa Binance se stala terčem útoku, při kterém podvodníci odcizili během několika minut kryptoměny v hodnotě přibližně 6,3 miliardy dolarů. Jedná se o největší kryptoměnovou krádež v historii, přibližně čtyřikrát větší než loňský útok na burzu Bybit. Binance se podařilo ve spolupráci s partnery zmrazit aspoň aktiva v hodnotě zhruba 3 miliard dolarů a slíbila, že veškeré ztráty pokryje z vlastních prostředků.
Zranitelnost CVE-2026-98432 s CVSS 9.8 odhalila AI od společnosti Anthropic. Jedná se o kritickou chybu v implementaci MPTCP (multipath TCP). Debian vydal patche 16.10. a 22.10., ale např. Ubuntu je zatím bez opravy. Více informací na The Hacker News.
Na Slovensku vznikla úplne nová rally hra, ktorá je zadarmo a funguje vo Windowse, Linuxe či na Macu. Greenie Rally má viac ako 50 tratí a vozidiel, šampionáty či turnaje. Má retro feeling a imituje automobilové hry z prelomu tisícročí. Vyskúšate prejsť všetky mapy na Škode 130RS?
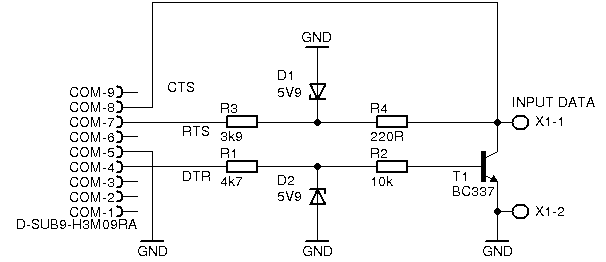
#define PORT 0x3f8
#define OFFSET_RIZENI_M 4

outb (0x00, PORT+OFFSET_RIZENI_M);    //nuluj registr rizeni modemu

log1 (PORT+OFFSET_RIZENI_M);          // inicializace sbernice a poskytnuti napajeni po dobu 1ms
usleep (1000);

log0 (PORT+OFFSET_RIZENI_M);          //-|master reset
usleep (500);                         //_|

log1 (PORT+OFFSET_RIZENI_M);          //-uvolnit sbernici
usleep (70);

statusCTS=inb (PORT+OFFSET_STAV_M);
if ((statusCTS & CTS_BIT)==0x00)      //-je nula na sbernici
   printf ("Ozval se\n");
Řešení dotazu:
void __usleep_test02 (int usecond) {
  struct timeval ts,te;                    //ts-time start; te-time end

  gettimeofday(&ts, NULL);                 //read start time in usec
  do {
      gettimeofday(&te, NULL);             //read end time in usec
  } while (te.tv_usec<ts.tv_usec+usecond); //when te(time end) < ts(time start) + usecond
} Ten cyklus ma spravny v pripade, ze nebude mit cekani delsi nez 1s (v pripade, ze mu to nekdo preplanuje a ono to pretece, tak uz na tom vlastne nezalezi a casem se mu to vzbudi stejne).Ne, zatuhne to. Dejme tomu: ts.tv_usec == 999999 a usecond == 3: bude se čekat až te.tv_usec >= 1000002, což nemůže nikdy nastat. Doporučuji alespoň následující, s tím, že nemůžete zadat usecond > 999999.
void __usleep_test02(int usecond) {
        struct timeval tv;
        time_t target_sec;
        suseconds_t target_usec;

        gettimeofday(&tv, NULL);
        target_sec = tv.tv_sec;
        target_usec = tv.tv_usec + usecond;
        if (target_usec >= 1000000) {
                target_sec++;
                target_usec -= 1000000;
        }

        while ((tv.tv_usec < target_usec) || (tv.tv_sec < target_sec)) {
                gettimeofday(&tv, NULL);
        }
}
Ta pasaz s casovacem mne velmi zaujala a poprosil bych o rozvedeni. Mikrosekunda je z puhledu systemu cca 1000-2000 instrukci CPU a to neni az tak mnoho.No, základem všeho je si zajistit RT prioritu procesoru (SCHED_FIFO), jinak se můžete jít koulet - jádro do Vaší čekačky přepne jiný proces a místo 2 us čekáte třeba 20 ms. Pokud máte RT prioritu, tak se to nestane, na druhou stranu jelikož standardní jádro není hard-RT, tak stejně nemáte 100% jistotu, ale už máte aspoň něco, s čím se dá rámcově počítat. Samotné čekání pak můžete udělat metodou busy wait - tj. tak jak to je naznačeno výše, čekáním v úzké smyčce na ten správný okamžik. Zablokujete tím kompletně jedno jádro procesoru, proto je potřeba vážit kdy a jak se tento postup nasadí. V defaultním nastavení linuxu je proti kompletnímu zablokování pojistka:
$ cat /proc/sys/kernel/sched_rt_period_us
1000000
$ cat /proc/sys/kernel/sched_rt_runtime_us
950000
... což znamená, že i přes RT prioritu bude váš proces donucen ke spánku pokud sežere více než 950000 us z 1000000 us okna (hodnoty v proc lze samozřejmě upravovat). To znamená že na jednoprocesorovém stroji budete mít šanci odladit tu chybně napsanou funkci na čekání :) Otázkou může být jak je jádro schopné říct kolik je přesně gettimeofday(). V linuxu jsou 2 časovače - clock source a event source. První lze jen číst a druhý lze i programovat na odeslání interruptu za nějakou dobu. Event source je obvykle podstatně méně přesný. Klasický časovač má 1000 Hz, HPETy mají v řádu MHz. Clock source má v optimálním případě přesnost 1 cyklu procesoru. Funkce gettimeofday() funguje tak, že se podívá na globální proměnnou kde je informace o čase posledního eventu a přičte k ní aktuální offset z clock source. Samozřejmě než se poté vyšaší přepnutí z kernel režimu do userspace atd. tak ještě nějaký čas uteče ale obvykle je to o dost méně než ta 1 us která nás zajímá. (Pro ultra přesné časování nesmíte volat funkce kernelu, ale vystačit si třeba s čtením TSC přímo v programu, což je zdroj dalšího opruzu...) Na druhou stranu pokud zavoláte nanosleep() tak si jádro dá určitou práci s tím, aby nastavilo event source jak nejlépe to jde (tam je toho dost, je potřeba váš časovač zařadit do RB stromu a kdovíco ještě) a pak si dá CPU voraz, takže skutečně tu mikrosekundu spíte. Bohužel kvůli různým overheadům a granularitě event sourcu budete mít trochu horší výsledky než u busy wait, na druhou stranu šetříte lesy :) Udělal jsem nějaké rychlé testy (viz přiložený program) a zdá se, že se výše popsané potvrzuje. Busy wait sežere 100% cpu a do 2ms okna se netrefí třeba 200x ze 100 000 pokusů. Na druhou stranu nanosleep nežere skoro nic, ale má overhead, se kterým musíte dopředu počítat a díky tomu trochu větší rozptyl.
kdezto aktivni cekani se netrefi v cca 6% pripadu... aspoň je vidět, že ani tahle metoda neni samospásná.
na jake verzi jadraPokud se pamatuju dobře, tak precizní časování se předělávalo někde kolem verze 2.6.17.
na takove kratke useky je aktivni cekani vhodnejsiStaré glibc uměly při volání nanosleep automaticky aktivně čekat do 2 mikrosekund pokud měl program RT prioritu, z novějších verzí to vyhodili.
Cist TSC bych radeji nedoporucoval, protoze se chova na ruznych architekturach jinakNení to věc architektury ale konkrétního modelu CPU. Já mám jeden celkem nový amd64 procesor a používá se dynamická změna rychlosti a TSC funguje dobře.
Tiskni
Sdílej:


 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz

 16.7.2010 10:07