Dne 21. října 2026 vydal projekt Node.js bezpečnostní aktualizace opravující deset zranitelností, včetně jedné umožňující potenciální vzdálené spuštění kódu (RCE). Nejzajímavější je CVE-2026-111497, chyba dekodéru Brotli, kterou objevili výzkumníci využívající OpenAI Codex Security. Chyba je v nativním dekodéru Brotli, nikoli v samotném JavaScriptu. Speciálně vytvořený komprimovaný vstup způsobí, že dekodér zamění
… více »Francouzský výrobce kabelů Nexans upozornil na napjaté dodávky elektrických kabelů. Výstavba nové výrobní linky pro některé typy kabelů může trvat přibližně tři roky. Datacentra potřebují rozsáhlé nízkonapěťové a středněnapěťové rozvody. Poptávka roste současně s modernizací elektrických sítí. Někteří odběratelé proto uzavírají výrazně delší dodavatelské smlouvy [Reuters].
Představena byla (𝕏) virtuální platforma FLYBENCH FPV, která nováčky provede zapojením a konstrukcí dronů.
Google Chrome 156 byl prohlášen za stabilní. Přehled novinek v poznámkách k vydání. Opraveno bylo 353 bezpečnostních chyb. Vylepšeny byly také nástroje pro vývojáře.
Indická společnost eMudhra po bezpečnostním incidentu, tj. kompromitaci soukromých klíčů osmi mezilehlých certifikátů své certifikační autority, opouští globální byznys s SSL/TLS certifikáty.
Dle Phoronixu zveřejnila společnost Trend Micro prostřednictvím programu Zero Day Initiative (ZDI) několik hlášení bezpečnostních zranitelností přímo na veřejném mailing listu LKML, přestože některé chyby dosud nemají opravu začleněnou do hlavní větve jádra. Mezi hlášenými problémy jsou dvě zranitelnosti s hodnocením CVSS 9.0, týkající se SMB Direct a KSMBD, které mohou umožnit vzdálené spuštění kódu. Další hlášení se týkají … více »
Správce hesel KeePassXC byl vydán ve verzi 2.8.0. Přechází na Qt 6, podporuje vkládání hesel s Waylandem, rychlé odemykání pomocí Polkitu nebo možnost nastavení klávesových zkratek (seznam změn).
Databáze DuckDB (Wikipedie) byla vydána ve verzi 2.0.0 LTS. S kódovým názvem Cinnamon Teal (čírka skořicová). S vyladěným protokolem Quack.
V implementaci Broadcom 802.11 byla zjištěna chyba ve zpracování WPS/EAP, týká se to SDK od roku 2010. Broadcom podle výzkumníka Quentina Kaisera odmítl CVE přidělit. Modemy Huawei a Technicolor jsou používány i v ČR, v LTE routerech, běžných domácích routerech a firemních přístupových bodech, jejich současný počet a zranitelnost konkrétních verzí však zatím neznáme. Více detailů a demo. GitHub / Broadcom 802.11 SDK Detection Toolkit.
Byla vydána nová verze 10.8 z Debianu vycházející linuxové distribuce DietPi pro (nejenom) jednodeskové počítače. Přehled novinek v poznámkách k vydání. Přibyl balíček DietPi WireGuard.
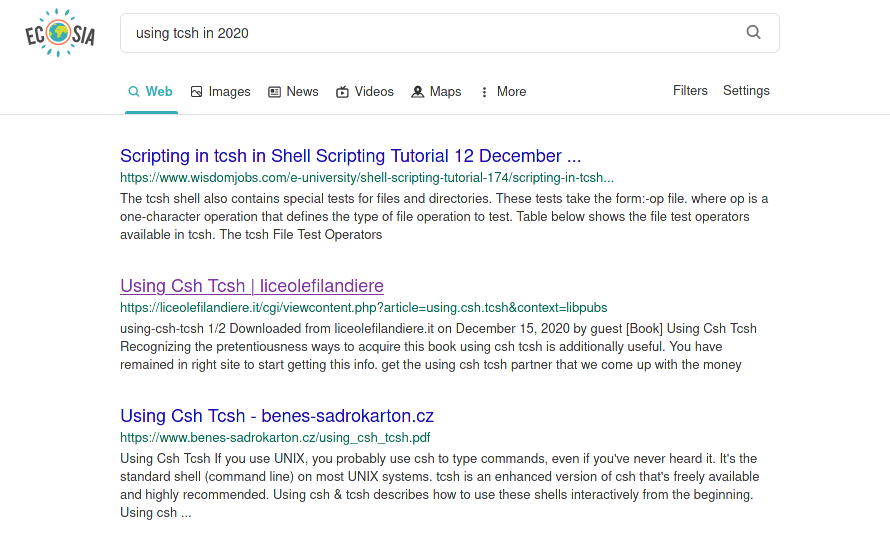
... ale na stránkach Benes-sadrokarton by som niečo takéto nehľadal (viď screenshot).
Ale ako to už obvykle býva, vysvetlenie je jednoduché. Prepadnutá doména, špekulant, nie je to odkaz na pdf ale na stránku ktorá ponúka stiahnutie "zaručene pravej a legálnej verzie" knižky (mám ju doma v papierovej podobe, celkom podarená na pomery O'Reilly).
Tiskni
Sdílej:


 31.12.2020 16:54
=^..^= AmigaPower® | skóre: 30
| blog: BLB
| Praha
 20.12.2020 20:26
xkucf03 | skóre: 50
| blog: xkucf03
Bohužel, web je čím dál více zamořený bezcenným automaticky generovaným obsahem. Často narazíš na „články“ náhodně poskládané z nakradených nebo vygenerovaných textů, do kterých jsou vložené (opět nakradené) obrázky. Na první pohled to vypadá relevantně, ale když to začneš číst, tak zjistíš, že to nedává smysl, že to neobsahuje žádnou hodnotnou informaci a že to ani nepsal člověk. Něco je strojově přeložené z jednoho jazyka do jiného, ale často nedával smysl ani ten původní text, ze kterého se překládalo. Do toho máš různé popisy produktů, programů, formátů atd. – opět automaticky vygenerované věty, aby toho bylo víc – z pár údajů které někde automaticky stáhli vyrobí odstavce textu.
apt-get install xyz a autor si prostě nahání e-ego.
21.12.2020 12:03
xkucf03 | skóre: 50
| blog: xkucf03
Dokud je autorem živá bytost, tak to má alespoň nějakou samoregulaci. Jistě, miliardy lidí na planetě dokáží vygenerovat spoustu zbytečného obsahu, ale stále je to řádově někde jinde, než když ten zbytečný obsah generuje počítač/AI.
Otázka je, jak ten obsah klasifikovat a najít v něm něco užitečného. Tady opět jsme/budeme odkázáni na nějakou AI. A to může vést k dost nepříjemným situacím. Ono už sama závislost na tak komplexní technologii je problém. Pak jde o to, kdo tu AI vytvoří, za jakým účelem a na jakých datech ji bude trénovat. To může vést k různým nežádoucím odchylkám (vývoje lidstva) a manipulacím.
Alternativou k AI může být nějaký reputační systém nebo fragmentace. Když např. budu vědět, že distribuce XY má hezky zpracovanou wiki plnou užitečných informací, tak můžu vyhledávat některé věci rovnou tam a ne na webu obecně. Tzn. rozpad na nějaké (polo)uzavřené skupiny a světy, se kterými budu mít zkušenost, že vědí něco zajímavého o určitém tématu. Tím se ten problém dělí do dvou kroků: nejdřív se ke mně musí dostat informace typu „o tématu X vědí něco skupiny/lidé A, B a C“, a pak už hledám konkrétní informaci u A, B a C.
Ono dost možná ten současný přístup, kdy zadám pár slov do jednoho univerzálního vyhledávacího pole, stisknu jedno univerzální tlačítko a čekám, že na první stránce výsledků dostanu to, co hledám, není dlouhodobě udržitelný a optimální.
 21.12.2020 17:23
Josef Kufner | skóre: 70
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz

 20.12.2020 17:13