Programovací jazyk Python byl vydán v nové major verzi 3.15.0. Podrobný přehled novinek v aktualizované dokumentaci.
BIGWORDS.PAGE je open-source webová aplikace, která po otevření odkazu v prohlížeči vykreslí přes celou obrazovku jednoduché informační sdělení. Zpráva i její nastavení jsou uložené v části URL za znakem #, například odkaz https://bigwords.page/#abclinuxu zobrazí jako velký bílý nápis 'abclinuxu' na černém pozadí. Obsah odkazu lze upravovat i vestavěným editorem, ten umožňuje nastavovat formátování a vizuální efekty textu, časovače, QR kódy a obrázky. Zdrojový kód je dostupný pod licencí MIT na GitHubu.
V neděli 11. října proběhne rotace klíče kořenové zóny. Podruhé v historii. Ondřej Filip na blogu CZ.NIC: "Pokud je pro Vás DNS protokol spíše výzva, ale přesto spravujete nějakou síť či DNS resolver, zkuste si jednoduchý test, který připravila firma Cloudflare na této adrese. Obzvláště zbystřit byste měli, pokud uvidíte nějaká červená políčka."
Vláda Spojených států se rozhodla vyřadit americkou softwarovou společnost Microsoft a několik dalších velkých technologických podniků z programu, který umožňuje kvalifikovaným zahraničním pracovníkům získat povolení k trvalému pobytu. Oznámila to včera administrativa amerického prezidenta Donalda Trumpa. Opatření zdůvodnila rozsáhlým zneužíváním programu, který je dlouhodobě terčem kritiky ze strany Trumpových příznivců, neboť prý znevýhodňuje americké pracovníky.
Datové centrum největší ruské technologické společnosti Jandex v Rjazaňské oblasti se stalo cílem dronového útoku a zastavilo provoz. Jandexu se někdy přezdívá „ruský Google“. Provozuje nejoblíbenější internetový vyhledávač v Rusku nebo aplikace pro objednávky jídla a taxi. Využívají jej desítky milionů lidí v rusky mluvících zemích.
Francouzská společnost Mistral AI představila Mistral Large 4 (interně přezdívaný 'le Chonk', volně přeloženo 'pořádný macek'), 'open-weight multimodální hybridní instruct-and-reasoning model s architekturou granulárního MoE, nativně podporující více jak 160 jazyků'. Model má přes jeden bilión parametrů, z nichž při práci využívá 49 miliard, kontextové okno o délce milion tokenů a obrazový enkodér o 1,6 miliardách parametrů.
… více »Svobodný multiplatformní herní engine Bevy napsaný v Rustu byl vydán ve verzi 0.20. Díky 227 přispěvatelům.
Simon Long oznámil Raspberry Pi Desktop pro PC a Mac s Intelem postavený na aktualizovaném Debianu 13 Trixie. S klientem Raspberry Pi Connect pro vzdálenou správu. Ke stažení je vedle Raspberry Pi OS pro Raspberry Pi.
ESP32-C3 adblock přemění lacinou vývojovou desku ESP32‑C3 na samostatný DNS blokovač nejenom reklamních domén, minimalistickou alternativu k populárnímu Pi-hole. ESP32-C3 adblock místo objemných názvů domén ukládá jejich 40-bitové FNV-1a hashe do flash paměti, které pak binárně prohledává, kontrola jedné domény trvá přibližně 10 milisekund. Blocklist pojme až 537 tisíc domén a lze jej spravovat přes webové rozhraní. Projekt zatím
… více »ArtCraft je sada open source aplikací pro práci s obrázky a videi "inspirovaných" aplikacemi od Adobe. Napsaných v Rustu. Pro MacOS, Windows i Linux. Běží také ve webovém prohlížeči. Aktuálně se jedná o 7 aplikací: PhotoCraft (Photoshop), VectorCraft (Illustrator), FilmCraft (Premiere Pro), LightCraft (Lightroom), PdfCraft (Acrobat), EffectCraft (After Effects) a DesignCraft (InDesign). Zdrojové kódy jsou k dispozici na GitHubu.
pip install ollama-ocrAk nemáme, nainštalujeme ollamu
curl -fsSL https://ollama.com/install.sh | sha stiahneme príslušné modely.
ollama pull llama3.2-vision:11b
ollama pull granite3.2-vision
ollama pull moondream
Batch OCR všetkých obrázkov zo zadaného adresára napr batch_ocr.py:
from ollama_ocr import OCRProcessor

# Initialize OCR processor
ocr = OCRProcessor(model_name='granite3.2-vision', max_workers=4)

# Process multiple images with progress tracking
batch_results = ocr.process_batch(
    input_path="/home/user/ocr",
    format_type="markdown",
    recursive=True,
    preprocess=True,
    custom_prompt="Extract all text, focusing on dates and names.",
    language="English"
)

# Create and write OCR text results to individual text files
for file_path, text in batch_results['results'].items():
    text_file_path = f"{file_path}.txt"
    with open(text_file_path, "w", encoding="utf-8") as text_file:
        text_file.write(text)

    print(f"\nFile: {file_path}")
    print(f"Extracted Text: {text}")


print("\nProcessing Statistics:")
print(f"Total images: {batch_results['statistics']['total']}")
print(f"Successfully processed: {batch_results['statistics']['successful']}")
print(f"Failed: {batch_results['statistics']['failed']}")
Nahádžeme obrázky do adresára /home/user/ocr. Spustíme skript
python3 batch_ocr.pya v adresári /home/user/ocr nájdeme txt súbory s OCR informáciou.
git clone https://github.com/imanoop7/Ollama-OCR.git
cd Ollama-OCR
pip install -r requirements.txt
cd src/ollama_ocr
streamlit run app.py
Tiskni
Sdílej:


A?
Takhle nějaký vzoreček na ukázku by nebyl? Abychom měli představu z čeho co vykouzlí a kolik dalšího sraní to pak ještě bude vyžadovat.
Ale je to AI, tak to musí být určitě lepší, ne? 
Pro mne to začne být zajímavé, až to zvládne i texty, jako je kupř. ten v příloze.

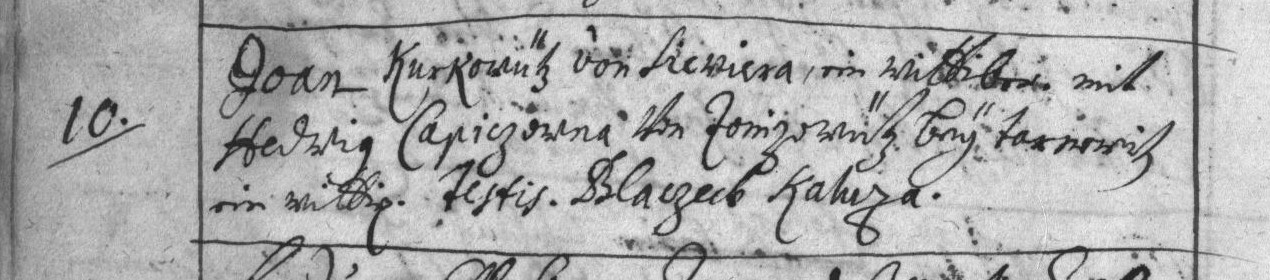
Běžný matriční záznam ze 17. století: 10. Junnius 1674 Joan Kurkowűts von [Li]ewiera, ein Wittiber mit Hedwig Capiczowna Won [J]omzowűtz beӳ Tarnowitz ein Wittib. Testis. Blaczech Kaluza. – link na originál.
Moje interpretace: 10.6.1674 [se oženil] Jan Kurkovic, z ?, vdovec (ein Wittiber) s (mit) Hedvikou, dcerou Kapicy (použití přípony -owna dokládá polský původ) z ? poblíž (bei) Tarnovic, vdovou (ein Wittib). Svědci (Testis) Plaček Kaluža.
Problém tohoto záznamu: Nejsem schopen blíže identifikovat obce ze kterých pocházeli. Tarnovice, od dob Jana Lucemburského patřící mezi země české koruny, jsou dnešní Tarnowskie Góry. V roce 1674 ještě pod legitimní vládou korunovaného (1656) českého krále Leopolda I. Habsburského. V oblasti, kterou si o 66 let později přivlastnilo Prusko (1740) a kterou roku 1922 rada Společnosti národů (takový předchůdce NATO, kde hrála prim Francie a Velká Británie) přiklepla obnovenému vazalskému Polsku, přestože si na ni brousilo zuby vazalské Československo (které by si tak interně vylepšilo poměr slovanů vůči germánům). Ale to je celkem fuk, protože dál do minulosti se už přes matriky stejně nedostanu. Starší záznamy (v češtině) (1654) jsou ještě stručnější. Který čech by se obtěžoval takovým detailem, jakým bylo jméno ženy 8-P, hlavně že to má datum.
Tak to si zřejmě ucvrnkneš štěstím, až tu po volbách zavládnou pořádky slovenského premiéra, když už ne tedy rovnou šéfredaktora. O přísloví „poturčenec horší turka” jsi slyšel?
No. Bez ruční práce to nepůjde, ale zefektivnit asi jo.
Každá slušná kniha obsahuje tiráž. Pokud máš mobil, který alespoň trochu slušně fotí, tak ber jednu po druhé na nacvakej si do něj ty tiráže. ALE JEN TIRÁŽ – tzn. že na té fotce bude jen tisk a bílé pozadí.
Ber polici po polici, ale systematicky.
Až s tím budeš hotov, přesuň ty fotky do kompu a můžeš na to poštvat netpbm. Abys neřekl, tady máš kolonu, kterou na to můžeš použít:
~# ${JPEGTOPNM} ${SOURCE} | \
   ${PAMCUT} -left 150 -width 1 | \
   ${PAMTOPNM} | \
   ${PPMTOPGM} | \
   ${PGMTOPBM} -threshold -value 0.5 > /tmp/strip.pbm
A na ten hotový soubor /tmp/strip.pbm poštvi tesseract a výstup ulož do souboru, pojmenovaného stejně jako ten snímek tiráže, akorát s příponou .txt. Výchozí soubor (snímek) ti poskytne přes exif čas pořízení snímku, který pak můžeš do těch souborů přidat.
A máš v podstatě k dispozici vše k tomu, abys mohl vygenerovat katalog a k němu adekvátní štítky s QR kódy, kterýma pak olepíš hřbety, ev. titulní listy těch knih.
Jak jsem napsal hned úvodem. Bez ruční práce se to neobejde a každou z těch knih budeš muset vzít minimálně jednou do ruky. Ale pak, až to budeš mít v těch textových souborech, už půjde hodně věcí automatizovat.
Ten čas je důležitý – pomůže ti setřídit ty soubory podle umístění knihy. Na konci police si cvakni třeba její číslo, nebo alespoň prázdný list. Pomůže ti to detekovat začátky a konce číselných řad.
A polepením je dobré pověřit nějakou pečlivou osobu, co nesere na to co dělá. Nemusí být moc chytrá ani zručná. Jenom by měla průběžně kontrolovat jestli lepí správný štítek do správné knihy.

Tak to si počkej až cbrpnk natrénuje tu Ollamu. Obávám se však, že do té doby zemřeš úderem do hlavy o ten regál, když si přišlápneš vous, co ti za tu dobu vyraší 8-D
ta tva predstava je stejne detinska jako kdyz muj 8 lety syn ma predstavu ze bude bydlet s nama i kdyz mu bude 30 let...Aby ses nedivil, zrovna mama-hotel ve třiceti je dnes celkem běžná věc.
Ochraptíš u prvního regálu. Nehledě na to, že ten "text2speech tool" si také schroustne nějaký ten čas a výpočetní výkon. Já na taková nástroj čekal přes 20 let, protože nebyl kdo by to za nějaký obolus překepal na stroji. A ta kvalita stejně není nic moc a vyžaduje korekci.
Chceš knížecí radu?
Zapomeň na rychlá řešení a začni něco dělat. Půjde to pomalu, ale jistě. Když počítáš na jednu knihu optimistických 30 sekund, tak s tím zabiješ 7 člověkodní při počtu 20 tis. publikací, a tolik jich tvá babi za svůj život nenastřádala. To se vsadím. Sám jich vlastním odhadem něco do tisícovky, včetně knihovny co jsem zdědil po bratranci, co byl podobný knihomol jako já.
Nedostatky tohoto řešení zmínil už Žako. Krom toho, tituly na hřbetu knih nejsou ani zdaleka samozřejmostí. Polovina knih co vlastním je nemá a mnoho jich ani nemá tiráž - samizdaty, archiválie, či hodně jeté rarity ulovené z antikvariátů.
Vím, že se opakuji, ale jsou oblasti na které AI nemá a nikdy mít nebude. Těžko ti najde knihu na základě pocitu a jen velice vágní vzpomínky na to co jsi kdysi dávno četl. Neví nic o tom, jak ra kniha byla velká, ani kde se přibližně ta pasáž nalézá. Takový Techický slovník Teyslerra Kotyšky má přes metr, ale také index. Ovšem mraky jiných knih nic takového nemají a přesto vím kde najdu založeno to co hledám.
reknu jednoduseji - mne nezajima, jak to nejde a proc to nejde.
Ale mělo by, příteli. Mělo by. Marně se neříká „dvakrát měř a jednou řež”. To máme u nás také jednoho takového, kterého to nezajímá, a pak se hrozně diví, kam až klesá priorita jeho požadavků.
Nemusíš se hnedka čertit. Tesseract není žádná AI, pracuje s hotovými modely které si musíš stáhnout, podle toho o jaký jazyk půjde. Umí zpracovat i frakturu, pokud máš ten správný model (tesseract-ocr-frk). Ale jsou prostě texty pro které žádný model není a nebude. Jako ten, který jsem uvedl.
K jejich vyluštění je totiž potřeba mraky jiných, zdánlivě nesouvisejících informací i jistou dávku intuice, kterou AI nemá.
Nechápu, proč se vždy stavíš proti všem do opozice.
To se ti jen zdá. Já jsem spočítal, kolik by mu asi tak zabralo zpracování tiráží. A když jsem odpovídal, šlo primárně o bezprostřední reakci na ten jeho šílený nápad – „to uz radsi si sednout a nahlas cist nazvy knih do mobilu azvukove soubory pak prehnat pres nejaky text2speech tool. akorat to by potrebovala nejakeho cloveka, co se mluvenim zivy, protoze cele hodiny cist (artikulovane, s durazem na cistotu vyslovovani), to by normalniho cloveka taky polozilo na lopatky (odrovnalo hlasivky).”
Text → Oko → Mozek → Prsty
vs.
Text → Oko → Mozek → Huba → audio záznam. a následně, audio záznam → Ucho → Mozek → Prsty
Kterážto realizace je (nejenom) časově mnohem náročnější. Je to stejně praštěné řešení, jako nahrávání dění na terminálu ve formátu mp4.
 18.3.2025 15:00
Bystroushaak | skóre: 36
| blog: Bystroushaakův blog
| Praha
Na obrázku jsou viditelné následující knihy (některé názvy jsou částečně čitelné):API call stojí pár korun.Další knihy nejsou kvůli úhlu či rozlišení jasně čitelné. Pokud potřebuješ informace o nějaké konkrétní knize, dej mi vědět!
- Farmakologie
- Farmakoterapie vnitřních nemocí
- Barevný atlas farmakologie
- Mechanika zemin
- Úvod do informatiky
- Medicína
- Psychoterapeutické směry
- No vnímání umění
- Moderní fyziologie
- Společenský rozvoj
- Základy psychologie
- Klinická propedeutika
- Základy pediatrie
- Lékařská péče o dítě
- Anatomie člověka
- Chirurgie pro studenty medicíny
 22.3.2025 15:11
jose17 | skóre: 44
| blog: Joseho_blog
| Bratislava
pip bez virtualneho environmentu? curl pipovany do shellu? ale no fuj!
Tady doporučují: „Řešením může být Tesseract který si ale musíš natrénovat.” Víc ti bohužel neporadím, protože tak do hloubky jsem s ním nikdy nedělal.
Já vím. Však jsem to nenabízel jako hotové řešení. Na té odkazované stránce píšou kde je kámen úrazu. Máš jenomdvě možnosti. Buď to zkusit. Nebo vyhledat někoho kdo to za patřičný obnos přepíše do počítače.
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz


 16.3.2025 21:21
 17.3.2025 17:54