Eben Upton oznámil další zdražení jednodeskových počítačů Raspberry Pi. Tentokrát 2 GB varianty o 12,50 dolarů. Nově 2 GB Raspberry Pi 4 stojí 67,50 dolarů a 2 GB Raspberry Pi 5 stojí 77,50 dolarů.
OpenMandriva ROME, tj. průběžně aktualizovaná (rolling) edice linuxové distribuce OpenMandriva, byla vydána ve verzi 26.09. Vedle Flatpaku také s podporou Snapu.
Edison Design Group po více než 30 letech zveřejnil zdrojový kód svého EDG C/C++ front-endu. Ten proslul širokou podporou standardů C++ a kompatibilitou s dialekty kompilátorů od Microsoftu, GNU, Clangu, Sunu a dokonce i s prehistorickým cfrontem. EDG byl použit například v kompilátoru Intel C++ Classic, kompilátoru NVCC od firmy NVIDIA pro platformu CUDA nebo v našeptávači kódu IntelliSense v produktech společnosti Microsoft. Projekt nyní spravuje organizace The C++ Alliance a kód je dostupný pod licencí Apache 2.0, doplněnou o výjimky projektu LLVM.
Pocket Tank je malé kapesní virtuální akvárium postavené na vývojové desce ESP32-S3-Touch-AMOLED-1.8. Na dvoujádrovém mikrokontroléru ESP32-S3 s 8 MB PSRAM a 16 MB flash paměti běží jak simulace akvária, tak i malý jazykový model určující chování rybiček. Lokální model o velikosti 7,56 MB se 14 miliony parametrů vznikl destilací modelu Gemma 4 26B, tedy učitele s 26 miliardami parametrů. Kromě firmwaru pro skutečný modul s AMOLED
… více »Open-source nástroj Jevstiller vytváří (destiluje) malý lokální model, který se průběžně učí z odpovědí komerční služby Jev. Běžné dotazy vyřizuje přímo na vlastním hardware, čímž může řádově zkrátit čas odezvy a snížit provozní náklady díky menšímu využívání zpoplatněného API. Nejisté požadavky Jevstiller posílá do Jevu, rovněž průběžně kontroluje náhodná dvě procenta dotazů Jevem. Pokud se lokální model začne s Jevem rozcházet,
… více »Konference LinuxDays 2026 proběhne již tento víkend 3. a 4. října v Praze v areálu ČVUT v Dejvicích na FIT. Konference LinuxDays 2026 znamená desítky přednášek a workshopů, zástup zajímavých osobností, místo pro setkání, spoustu nových nápadů a informací a stánky řady různých projektů: Fedora, openSUSE, vpsFree.cz, Mozilla, MacGyver - bastlíři SH, OpenAlt a mnoho dalších. Vstup je volný.
Microsoft oznámil, že WSL kontejnery (WSLC) aneb linuxové kontejnery ve Windows Subsystem for Linux (WSL) jsou již obecně dostupné. Současně popsal jejich architekturu.
openSUSE Leap 16.1 vstoupil do RC fáze. Nově lze instalovat jako standardní systém (Standard) nebo jako neměnný systém s atomickými aktualizacemi (Immutable). Samostatná neměnná distribuce openSUSE Leap Micro končí.
Byl vydán Mozilla Firefox 157.0. S nejvýraznější vizuální proměnou za poslední roky. Přehled novinek v poznámkách k vydání a poznámkách k vydání pro vývojáře. Řešeny jsou rovněž bezpečnostní chyby. Nový Firefox 157 bude brzy k dispozici také na Flathubu a Snapcraftu.
Rodina produktů Raspberry Pi se rozšířila o Raspberry Pi Smart Display Module. Deska pro Raspberry Pi Compute Module 5 se zasouvá přímo do displejů dle specifikace Intel SDM. Cena desky je 30 dolarů.
Tak jak jsem psal v komentářích předminulého zápisu, spatlal jsem logaritmus v SSE2 instrukcích. Trošku jsem otestoval jeho rychlost a tu jsou výsledky + zdroják.
Měření jsem prováděl 5x a vzal průměrnou hodnotu (použil jsem time). Počet iterací byl 500000000. SSE2 logaritmus to zvládnul za 21.52s a logaritmus z C math knihovny 35.06s.
; log_x86_64.asm

BITS 64

SECTION .text
global sse2_log_base_e

; SSE2 implementation of natural logarithm, x86_64 version
; based on that found at http://gruntthepeon.free.fr/ssemath/
; Modified to operate on doubles instead of floats
;
; input xmm9
; output xmm9
;
; eats xmm10-xmm15
;

sse2_log_base_e:
    movapd xmm9, xmm0 ; Kvůli C testu a gcc, který první double šoupá do xmm0
                      ; tohle tu nebude v kresliči grafů
                      ; kterej to bude šoupat do xmm9
    movapd xmm15, xmm9
    maxpd  xmm9, [rel double_min_norm_pos]
    movdqa xmm12, xmm9

    andpd    xmm9, [rel double_inv_mantisa_mask]
    movapd   xmm14, [rel double_0p5]
    xorpd    xmm10, xmm10
    psrlq    xmm12, 52
    psubq    xmm12, [rel double_exponent_bias]
    movapd   xmm11, [rel double_1]

    pshufd   xmm12, xmm12, 0xd8
    cvtdq2pd xmm12, xmm12

    orpd     xmm9, xmm14
    cmplepd  xmm15, xmm10
    movapd   xmm10, xmm9
    movapd   xmm13, xmm9
    cmpltpd  xmm10, [rel double_cephes_SQRTHF]

    subpd  xmm9, xmm11
    andpd  xmm13, xmm10
    addpd  xmm12, xmm11
    andpd  xmm11, xmm10
    movapd xmm10, [rel double_cephes_log_p0]
    addpd  xmm9, xmm13
    subpd  xmm12, xmm11
    mulpd  xmm10, xmm9
    movapd xmm13, xmm9
    movapd xmm11, xmm12

    mulpd  xmm12, [rel double_cephes_log_q2]
    mulpd  xmm13, xmm9

    addpd  xmm10, [rel double_cephes_log_p1]
    mulpd  xmm11, [rel double_cephes_log_q1]
    mulpd  xmm1, xmm9
    addpd  xmm10, [rel double_cephes_log_p2]
    mulpd  xmm10, xmm9
    addpd  xmm10, [rel double_cephes_log_p3]
    mulpd  xmm10, xmm9
    addpd  xmm10, [rel double_cephes_log_p4]
    mulpd  xmm10, xmm9
    addpd  xmm10, [rel double_cephes_log_p5]
    mulpd  xmm10, xmm9
    addpd  xmm10, [rel double_cephes_log_p6]
    mulpd  xmm10, xmm9
    addpd  xmm10, [rel double_cephes_log_p7]
    mulpd  xmm10, xmm9
    addpd  xmm10, [rel double_cephes_log_p8]
    mulpd  xmm10, xmm9

    mulpd xmm10, xmm13
    mulpd xmm13, xmm14
    addpd xmm10, xmm11
    subpd xmm10, xmm13
    addpd xmm9, xmm10
    addpd xmm9, xmm12
    orpd  xmm9, xmm15
    movapd xmm0, xmm9 ; kvůli gcc a C testu
    ret

SECTION .data align=16

    ; double
    ;   1b - sign
    ;  11b - exponent (mantisa)   -1023
    ;  52b - significand
    ;  64b - total

    double_mantisa_mask:     dq 0x7FF0000000000000,0x7FF0000000000000 ; mask for exponent
    double_inv_mantisa_mask: dq 0x800FFFFFFFFFFFFF,0x800FFFFFFFFFFFFF ; inverted mask for exponent
    double_sign_mask:        dq 0x8000000000000000,0x8000000000000000 ; mask for sign
    double_inv_sign_mask:    dq 0x7FFFFFFFFFFFFFFF,0x7FFFFFFFFFFFFFFF ; inverted nasj for sign
    double_exponent_bias:    dq 0x00000000000003FF,0x00000000000003FF ; 1023 (subtract from exponent to get real one)
    double_min_norm_pos:     dq 0x0010000000000000,0x0010000000000000 ; the smallest double

    double_0p5:              dq 0x3FE0000000000000,0x3FE0000000000000 ; 0.5
    double_1:                dq 0x3FF0000000000000,0x3FF0000000000000 ; 1.0

    double_cephes_SQRTHF:    dq 0x3FE6A09E667F3BCD,0x3FE6A09E667F3BCD ; 0.707106781186547524
    double_cephes_log_p0:    dq 0x3FB204376245245A,0x3FB204376245245A ; 7.0376836292E-2
    double_cephes_log_p1:    dq 0xBFBD7A370B138B4B,0xBFBD7A370B138B4B ; -1.151461031e-1
    double_cephes_log_p2:    dq 0x3FBDE4A34D098E98,0x3FBDE4A34D098E98 ; 1.1676998740000000e-1
    double_cephes_log_p3:    dq 0xBFBFCBA9DB73ED2C,0xBFBFCBA9DB73ED2C ; -1.2420140846000000e-1
    double_cephes_log_p4:    dq 0x3FC23D37D4CD3339,0x3FC23D37D4CD3339 ; 1.4249322787000000e-1
    double_cephes_log_p5:    dq 0xBFC555CA04CB8ABB,0xBFC555CA04CB8ABB ; -1.6668057665000000e-1
    double_cephes_log_p6:    dq 0x3FC999D58F0FBE3E,0x3FC999D58F0FBE3E ; 2.0000714765000000e-1
    double_cephes_log_p7:    dq 0xBFCFFFFF7F002B13,0xBFCFFFFF7F002B13 ; -2.4999993993000000e-1
    double_cephes_log_p8:    dq 0x3FD555553E25CD96,0x3FD555553E25CD96 ; 3.3333331174000000e-1
    double_cephes_log_q1:    dq 0xBF2BD0105C4242EA,0xBF2BD0105C4242EA ; -2.1219444000000000e-4
    double_cephes_log_q2:    dq 0x3FE6300000000000,0x3FE6300000000000 ; 6.9335937500000000e-1
/* test.c */

#include <stdio.h>
#include <math.h>

#define SSE2_LOG

#ifdef SSE2_LOG
double sse2_log_base_e(double b);
#endif

int main()
{
	size_t i;
    double a;
    double b;


    for (i = 0; i < 500000000; ++i)
    {
    	a = (double)i;
        #ifdef SSE2_LOG
        b = sse2_log_base_e(a);
        #else
        b = log(a);
        #endif
    }

    return 0;
}
yasm -f elf64 -o log.o log_x86_64.asm
gcc -o test log.o test.c -lm
Jediné, v čem sse2 logaritmus moc neválí je přesnost výpočtu, C log to zvládne trochu lépe. Ještě to zkusím trochu vytunit 
Prosím, prosím, mohl bys opravit BUG, kdy je všechno moje < a > po náhledu v textovém okně nahrazeno špičatejma závorkama a musím to zas přepisovat na < a >?
A ještě jsem zapomněl zmínit, že ten SSE2 logaritmus je schopen počítat 2 najednou (double v horní i dolní 64bit části xmm registru), takže ten čas C logaritmu vynásobte tak ... 1,8x, ať nežeru
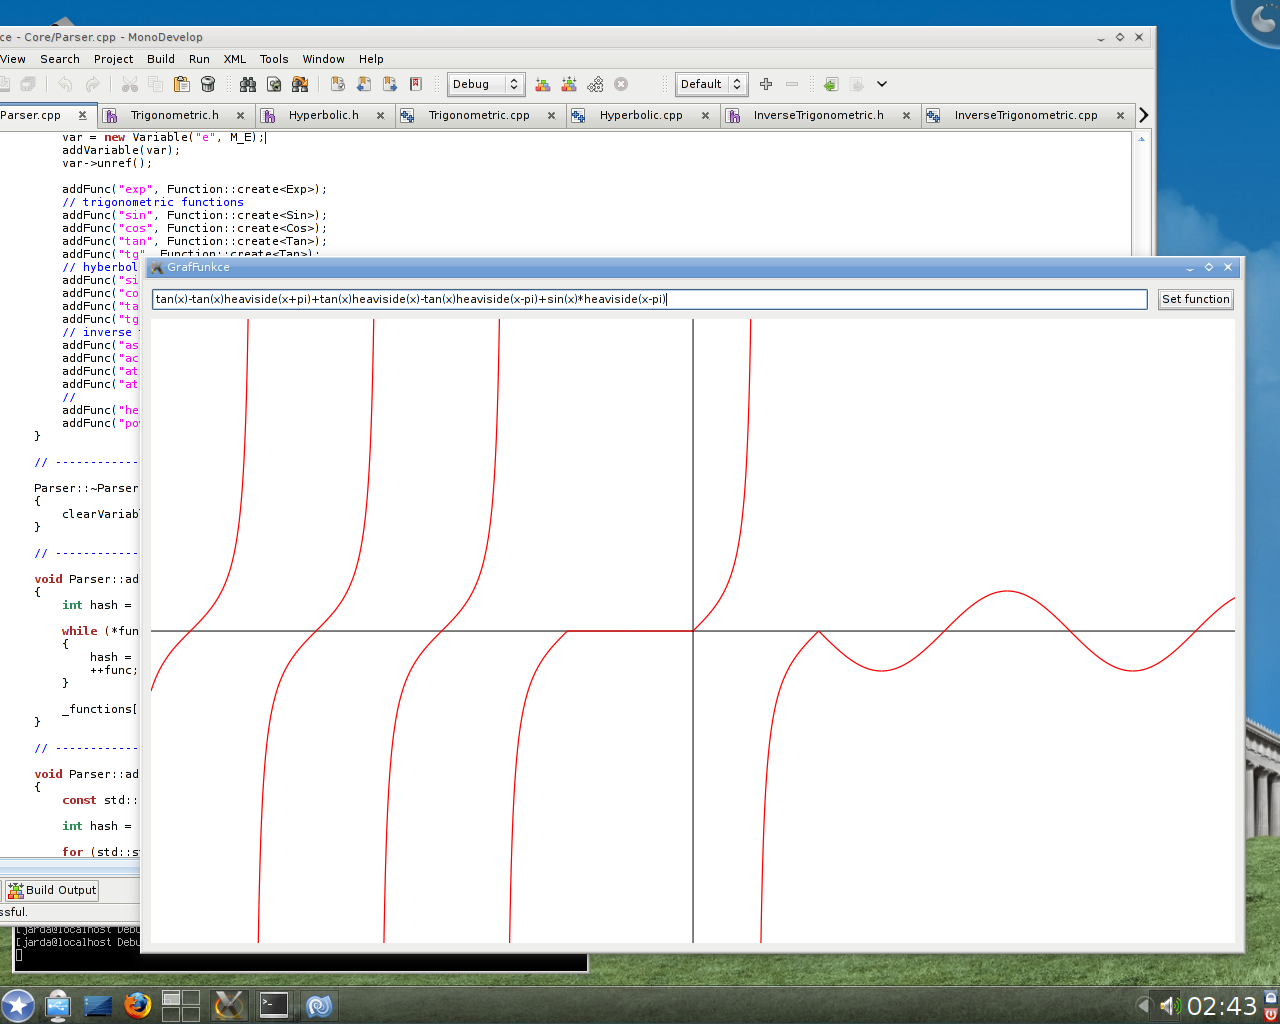
BTW pokud někdo přehlídl kreslič funkce na screenu desktopu, tak tu. Je to sice starší verze, ale moc se toho zatim nezměnilo
Tiskni
Sdílej:


Ten bug je nahlasenej, pokud se nepletu. Tak to priste muzes pripsat na bugzillu. BTW: to tak fakt zatim nikomu tolik nevadilo, ze to neni opraveny?
BTW: Dobry reseni je zkopirovat si text pred odeslanim do nejakyho editoru, provest nahled a zkontrolovat a kdyz je to OK, tak text z textovyho pole vymazat a nakopirovat zpatky original z textovyho editoru:)
 4.6.2009 22:56
Jardík | skóre: 40
| blog: jarda_bloguje
4.6.2009 22:58
Jardík | skóre: 40
| blog: jarda_bloguje
Problém SSE věcí je, že dělají většinou jenom část věcí proti tomu co dělá FPU, či math knihovna.
Klasická math knihovna, či FPU dělá:
1) test definičního oboru a infinite x
2) výpočet hodnoty funkce (s přesností o pár bitů vyšší, než je výstup)
Problém je, že čím větší přesnost, tím je výpočet pomalejší. FPU počítá na 80 bitů plus několik dalších bitů interně, takže přesnost je velmi vysoká. Těmi několika bity navíc se velmi potlačuje vliv zaokrouhlovacích chyb při výpočtu.
Dále C standardní knihovna bohužel kromě výpočtu ještě nastavuje různé math error kódy, takže je to dost brzdí.
Zatím jsem ještě nepotkal žádný SSE algoritmus, který byl použit pro rychlostní srovnání, který by dělal plný rozsah akcí toho, s čím se srovnává.
4.6.2009 23:27
Jardík | skóre: 40
| blog: jarda_bloguje
4.6.2009 23:30
Jardík | skóre: 40
| blog: jarda_bloguje
4.6.2009 23:34
Jardík | skóre: 40
| blog: jarda_bloguje
4.6.2009 23:42
Jardík | skóre: 40
| blog: jarda_bloguje
4.6.2009 23:45
Jardík | skóre: 40
| blog: jarda_bloguje
4.6.2009 23:59
Jardík | skóre: 40
| blog: jarda_bloguje
Při 0 mi to vrátí -inf, C knihovna NaN, správně je -inf. Tak neotravujte
Základní problém je, že ani netušíte, co Váš algoritmus dělá, ale musíte to zkusit, namísto toho, abyste věděl, co jste navrhnul.
Takže já bych měl důvěru ve Vaše algoritmy takovou, že bych raději použil cokoli jiného.
Možná na běžných algoritmech se dá hádat, ale v numerické matematice musíte vědět. Jinak vycházejí blbosti a testováním podprogramu jako black box na skutečnou příčinu samozřejmě nepřijdete.
Jinak matematické funkce nad float čísly se neřídí čistou matematickou, protože počítačový float má velmi daleko k ideálním reálným číslům. Pro běžného programátora je rozdíl mezi „pseudoreálnými čísly typu floating point“ a dokonalými reálnými čísly, které používá matematika celkem zanedbatelný. Ale při takových výpočtech je nutné s ním počítat. Například čísla typu floating point nejsou spojitou množinou, není u nich zaručena asociativnost jako u dokonalých reálných čísel, atd..
Skutečné výsledky nad floating point čísly se proto v limitních případech neřídí vždy podle matematiky, ale podle celosvětově a jednotně přijaté normy IEEE-754, která přesně a naprosto do posledního detailu definuje, jak se to má chovat. Tudíž správně je log(0) = NaN.
 5.6.2009 00:38
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
5.6.2009 09:19
Jardík | skóre: 40
| blog: jarda_bloguje
5.6.2009 09:22
Jardík | skóre: 40
| blog: jarda_bloguje
FPU vypočítá ten logaritmus za stejný čas jako push instrukci
 5.6.2009 00:04
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
5.6.2009 09:21
Jardík | skóre: 40
| blog: jarda_bloguje
5.6.2009 09:35
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
5.6.2009 14:19
Jardík | skóre: 40
| blog: jarda_bloguje
5.6.2009 17:39
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
Leoši, Prosím, prosím, mohl bys opravit BUG, kdy je všechno moje < a > po náhledu v textovém okně nahrazeno špičatejma závorkama a musím to zas přepisovat na < a >?Skoro bych si tipnul, že Leoš tě blokuje...
5.6.2009 18:30
Jardík | skóre: 40
| blog: jarda_bloguje
5.6.2009 20:35
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
Jednoduchá odpověď. Tam už tě ignorovat nemůže.
5.6.2009 18:32
Jardík | skóre: 40
| blog: jarda_bloguje
11.6.2009 10:57
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
System.currentTimeMillis() na zacatku a na konci main(), tzn. pocita se do toho i inicializace JNI knihovny, alokace poli pro vysledky apod. (pri spousteni z konzole jako JAR a mereni s pomoci time je to asi 31 vterin, protoze se tam pocita cely start VM apod.)
Ani radsi nechtej vedet jak by to dopadlo, kdybych vzal PowerPC procesor, ktery je chronologicky a taktem ekvivalentni tvemu (napr. 970MP na 2.5 GHz, uvedeny zhruba rok pred tvym procesorem)...
11.6.2009 17:30
Jardík | skóre: 40
| blog: jarda_bloguje
Ale taky ten můj procík je úsporná verze s 512kB L2 cache, takže je to takový pomalý kšunt. Věřím, že kdybych to testoval na Intel Core 2 Duo na NB, tak to dopadne líp.
11.6.2009 17:37
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
11.6.2009 18:13
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
Ted jeste nove ARM Cortexy, ktere taky maji svoji SIMD jednotku a ktere nejspis Atomum pekne zatopi u zadnice... Ja pevne doufam, ze to bude x86, kdo v budoucnu zemre. Ma na to vek a zdravotni stav a nazivu ji drzi jen Microsoft se svym monopolem. Ne nadarmo je soucasny nejrychlejsi pocitac na svete tvoren ze 2/3 PowerPC procesory...
Existuje Accelerate.framework, ale na ten bych si asi musel napsat JNI most, aby fungoval v Jave a to se mi nechce. Navic kdyz uz Java vyuziva SSE...
Mluvím samozřejmě o desktopech (na mobilech fandím armu, je to úsporný procesor).
11.6.2009 20:37
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
Ty léta výzkumu a vývoji překladačů pro x86, to by bylo škoda vyhodit, ne?Ne
To je jak kdybys rikal, ze by bylo skoda zapomenout Michaela Jacksona, kdyz uz ma za sebou tolik plastickych operaci a tak se snazil... x86 je proste neperspektivni a je zbytecne ji priohybat (napr. nebyla pri svem poceti na rozdil od PPC tvorena s planem na 64bitu), kdyz jsou tu jine, cistsi, architektury...
Já osobně mám tu architekturu rád, a radši si koupím x86 procesor, než nějaký powerpc nebo armTak jiste, z pragmatickeho pohledu neni co resit. Apple se v pondeli s PPC rozloucil definitivne, Windows (uz) na tom taky nejedou a pocet linuxovych dister, ktera PPC berou alespon trosku vazne, se taky spise snizuje a kdyz, tak je stejne optimalizace pro tu platformu temer nulova... V embedded zarizenich pro divokou matematiku (medicina, armada, avionika, prumysl, supercomputing, herni konzole) ale PPC prospiva, protoze tam nepotrebuje za sebou tahat onu kouli ve forme "musis podporovat Windows, jinak jsi nezajimavy"...
12.6.2009 08:27
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
Nemyslím to tak, že bych tu architekturu nesnášel, ale z pohledu současnosti (a podle mě i budoucnosti) má smysl věnovat se architektuře, kterou má na desktopu každý.To je prece jak kdybys tvrdil, ze je lepsi se vykaslat na Linux a venovat se Windows, protoze to stejne ma na desktopu kazdej... :/
Pokud se bavíme o serverovém trhu, tak tam to bylo vždycky jiné, ale třebá i já mám server x86, a popravdě neznám důvod pro výběr jiné architektury.Tak ono popravde to PPC ani pro ten serverovy trh neni prilis zajimave, protoze na serveru (ted myslim web, posta, enterprise) tezko nejak casto vyuzijes vypocty v plovouci radove carce... Kdyz mas ale aplikaci, ktera ty vypocty nekde potrebuje, tak je dobre mit smiseny cluster a vypocty prenechavat nodum s PPC procesorem, na kterych bezi specialne optimalizovany SW (tady se dostavame zas k jine veci: je dost mozne, ze cena PPC reseni + optimalizace SW nakonec bude vyssi, nez kdyz se to same vyresi hrubou tupou silou x86 serveru a neoptimalizovaneho SW.... coz je debilni, ale nejspis to tak bude :/). A to se dotyka i desktopu. Hudba, video, desktopove efekty. Apple nelhal, kdyz rekl, ze Power Mac je prvni pocitac, ktery umoznuje lidem mit doma na stole 1 GFLOPS. Muj staricky Power Mac na 733 MHz ma 1.3 GFLOPS, pokud se pouzije AltiVec. Intel tohohle byl schopen pouze s nekolikanasobkem taktu procesoru... Ovsem je fakt, ze v dobe OpenCL se CPU celkove posouva do trochu jine role... zustava mu ta "nudna" prace a k zajimavym vecem se dostane cim dal mene. Otazka je, jestli to prave nebylo iniciovano tim, ze x86 -- jakozto vsudyprtomna a de fakto diky MS nenahraditelna architektura -- konstantne nezvladala v FP vypoctech nejak vic zazarit...
 ?
Jinak s tím posledním odstavcem souhlasím, ale na druhou stranu, jaký by v tom případě mělo smysl vyvíjet procesory? Výrobci se vždycky budou snažit o vývoj a hlavně prodej, takže se karta může i obrátit, a budou výkonné procesory s možností provádět grafiku tam (myslím, že Intel přímo něco takového dělá, ale neznám podrobnosti).
12.6.2009 09:48
Daniel Kvasnička ml. | skóre: 52
| blog: The Joys and Sorrows of Being an IT Freak
| Ostrava
A tady je zakopaný pes, proč by měl někdo podporovat dražší architekturu, když existuje mnohem levnější a z časového hlediska naprosto vyzkoušená architektura, pro kterou jsou psané skoro všechny programy?Ale jak vis, ze PPC architektura je drazsi? Pocitace Apple v dobe PPC staly hodne, to jo. Ale to prece neznamena, ze ta architektura je draha. Pokud bys objednaval ve velkych mnozstvich, tak si myslim, ze bys klidne mohl postavit PPC desktop se stejnym pomerem vykon/cena jako x86, ne-li lepsim. Otazka je, co bys na tom provozoval
OS X tezko, Win ne, Linux s nulovou optimalizaci...?
V soucasny dobe je to fakt dobry tak akorat na vypocty a nebo casem, az se Linux vic rozsiri a bude stat za to do toho investovat, tak pro desktopy a hlavne pro n(et|ote)booky, jelikoz vykon/watt byl u PPC (kdyz nepocitam serverove POWER a z nich odvozene G5) vzdycky dobry...
protoze tam nepotrebuje za sebou tahat onu kouli ve forme "musis podporovat Windows, jinak jsi nezajimavy"..."Koule" podpory Windows je spíš než co jiného jenom výmluva. Takový Efficeon Windows podporoval, výkonově byl na tom podobně jako odpovídající procesory x86, spotřeba podstatně menší, ale ani tak se neuchytil.
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz