Byla oznámena beta verze nového video kodeku Pyrowave pro streamování her v Steam Remote Play. S vysokou propustností a nízkou latencí. S podporou HDR a YUV 4:4:4.
Byl vydán Sublime Text 4 Build 4213. Sublime Text (Wikipedie) je proprietární multiplatformní editor textových souborů a zdrojových kódů. Ke stažení a k vyzkoušení je zdarma. Pro další používání je nutná licence v ceně 99 dolarů. Spolu se Sublime Merge je cena 168 dolarů.
Firma Anthropic, tvůrce AI modelu Claude, začala v oblasti Sanfranciského zálivu v tichosti provozovat vlastní biotechnologickou laboratoř. Anthropic prý chce pomocí AI urychlit hledání léků na nemoci, jimž farmaceutický průmysl dle názoru firmy věnuje příliš málo pozornosti. Firma tvrdí, že laboratoř se zatím soustředí především na základní biologii, nikoli přímo na vývoj léčiv. Farmaceutický výzkum je pro generálního ředitele Daria Amodeie velice osobní téma, jeho otec zemřel na hepatitidu C několik málo let před objevením účinné léčby.
Vědci z Googlu dokončili mapu všech neuronových spojení v mozku (tzv. konektom) samečka mušky octomilky obecné (drosophila melanogaster), hlavním cílem je komparativní analýza s již zmapovaným mozkem samičky. S tímto veřejně dostupným modelem, čítajícím přibližně 160 000 neuronů, se začali bavit nadšenci. Mozek mouchy pohání experimentálního kryptoburzovního bota Stonkfly, případně si zahrál počítačové hry Beat Saber, Mario64 a samozřejmě DOOM (gameplay videa). Ani mozek samičky nezůstal stranou, vyzkoušel si Minecraft.
Alibaba Cloud je dalším sponzorem nadace Omacom Foundation stojící za linuxovou distribucí Omarchy. Přislíbená částka je 3 miliony dolarů, tj. 1 milion dolarů ročně po dobu tří let. Stejná částka jako u DigitalOcean.
Byla vydána nová verze 262 správce systému a služeb systemd (Wikipedie, GitHub).
Canonical oznámil vydání Zephyr 26.04 LTS. Jedná se o komerční distribuci operačního systému pro mikrokontroléry Zephyr (Wikipedie) s podporou až 15 let.
Gravity Linux je linuxová distribuce určená pro Apple Silicon s čipy M4 a novějšími. Vydána byla alfa verze pro M4 Mac mini. Gravity Linux je fork Asahi Linuxu.
Hister je osobní soukromý vyhledávač, který lze provozovat na vlastním stroji. Umí prohledávat lokální soubory, importovat historii a záložky z webových prohlížečů, procházet vybrané weby a pomocí rozšíření pro Firefox a Chrome indexovat obsah právě navštívených stránek. Nad vytvořeným indexem pak nabízí vyhledávání prostřednictvím webového rozhraní, příkazové řádky a díky podpoře MCP i nástrojům umělé inteligence. Tento
… více »Ministerstvo dopravy uznalo prozatímní schválení asistenčního systému Tesla FSD Supervised vydané nizozemským schvalovacím orgánem RDW. Připojilo se tak k Nizozemsku a dalším pěti evropským státům. Systém je díky tomuto rozhodnutí možné používat za podmínek prozatímního schválení také na území České republiky. Tesla FSD Supervised je asistenčním systémem úrovně 2 podle klasifikace SAE (částečná automatizace řízení). Řidič se
… více »Při zkoumání délek souborů jsem demonstroval některé modelové problémy, které při použití těchto nástrojů automatizované kanceláře vznikají. Také jsem upozornil na určité celkové zrádné problémy spojené s návrhem Unixu a informačních technologií vůbec, aby před nimi čtenář uživatel nebo návrhář byl varován.
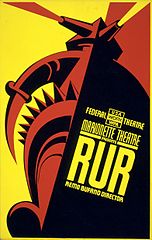
Zdroj: Library of Congress (public domain).
Plakát na Čapkovu vědeckofantastickou hru R.U.R. v New Yorku v roce 1939. Na tuto hru dnes narazíme. Čapkova hra R.U.R. je zdrojem slova robot v různých světových jazycích.
Řekl bych, že nejprominentnější částí obsahu projektu Gutenberg jsou licenční záhlaví a zápatí, která dokážou být obzvláště otravná, chcete-li se jich zbavit. Na Internetu jsou různé diskuse a výtvory, jak tyto pasáže odstranit. Dojem, který jsem dostal, sumarizuje tato otázka na Stack Overflow: „Zkoušel jsem různé metody, jak odstranit licence z textů Projektu Gutenberg (…), ale nepřijde mi, že bych byl schopný přijít na spolehlivý, automatický postup, který nevyžaduje lidskou intervenci.“ Stack Overflow je webová stránka, kde si programátoři navzájem pomáhají řešit různé problémy.
Díval jsem se na předložené návrhy ostatních přispěvatelů, žádný se mi ale nezdál dostatečně důvěryhodný a elegantní, abych ho vyzkoušel.
Níže v článku použijeme statistickou metodu na filtraci archaismů a přímé řeči. Nepředpokládám ale, že by tyto právnické texty obsahovaly znatelné množství archaismů ani přímé řeči. Navíc jsou si podobné, takže pokud budou nějaké zbytkové množství těchto prvků obsahovat, budou mít tendenci je obsahovat všechny soubory.
Nakonec nás zajímají delší literární díla, vůči jejichž rozsahu bude velikost takové licence relativně malá. Ze zkušeností přispěvatelů na Stack Overflow se zdá, že problém je náročný, proto záhlaví a zápatí filtrovat nebudeme – nepřijde mi to adekvátní vynaložené námaze a potenciálnímu přínosu.
Taková filtrace je ale nutná, pokud člověk dělá jazykový korpus pro účely lingvistiky. Korpus je co největší soubor textů zpravidla v jednom jazyce, a to pokud možno reprezentativní. Statistický výzkum nebo strojové učení na korpusu, který by obsahoval takové právnické texty neodstraněné, by snadno došel k hrubě chybným závěrům. Například ve duchu, že každé literární dílo v anglickém jazyce, bez výjimky, obsahuje značný počet výskytů slov jako GUTENBERG, (TM), legální, povinnost, smlouva, záruka atd., což je samozřejmě absurdní závěr o běžném jazyce.
Zdroj: Lancaster University.
Britský národní korpus obsahuje 100 miliónů slov v britské angličtině ze široké palety zdrojů z konce 20. století. Jeho úmyslem je nabídnout reprezentativní vzorek mluvené a psané angličtiny z této doby. SYN2009PUB Českého národního korpusu dosahuje 700 miliónů slov publicistických textů.
Jedním z kritérii pro čtivost článku, jež použijeme, bude přítomnost přímé řeči. Ta se často vyskytuje v románech, povídkách a naopak se nevyskytuje vůbec nebo jen velmi málo v patentech, slovnících, encyklopediích, telefonních seznamech, příručkách, přednáškách či vědeckých dílech.
Jako jednoduchý indikátor přímé řeči jsem použil uvozovky, za kterými se vyskytuje anglické slovo já, ty, on, ona, protože. Toto odpovídá anglickému charakteru stavby věty. Pro češtinu by možná byla vhodná změna. Použijeme ošetřený výpis souborů jménem clean2.txt, který jsme si vytvořili v pátém dílu seriálu. Výsledný seznam s počty výskytů náznaku přímé řeči pošleme do souboru prima_rec.txt.
#!/bin/bash

{
for jmeno_souboru in $(cut -d ' ' -f 11- clean2.txt)
do
 LC_ALL=C grep -c '"\(I\|You\|He\|She\|Because\)\>' "$jmeno_souboru" \
| tr '\n' ' ' &&
echo "$jmeno_souboru"
done
} \
| tee prima_rec.txt
Tento filtr bude mít jeden žádoucí vedlejší efekt: protože slova přímé řeči byla definována anglická, automaticky zamítne texty francouzské, německé atd., které se v projektu Gutenberg také vyskytují, ovšem ne v takové míře jako texty anglické. Drtivá většina textů v projektu je anglických. Pokud to čtenáře zajímá, projekt Gutenberg má seznamy knih německých, francouzských, ale třeba i českých, kde jsou ovšem díla pouhých osmi autorů, mezi nimi R.U.R. od Karla Čapka.
Příkaz poběží dlouho, protože musí progrepovat všech 20 GB textových dat. I kdyby byl disk schopen servírovat data plnou čtecí rychlostí 60 MB/s (rychlost mého
disku), jen načtení dat z disku by trvalo 20000/60/60 = 5,5 minuty. Naštěstí jsme alespoň urychlili grep pomocí LC_ALL=C.
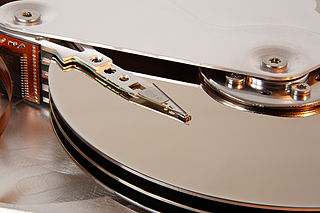
Obrázek: Eric Gaba via Wikipedia (CC-BY-SA 3.0).
Úzkým hrdlem u sekvenčního čtení z pevného disku jsou sériové hlavy, kde bity musí chodit jeden za druhým. Při rychlosti disku 60 MB/s a 6 površích musí každá hlava zvládat 10 MB/s neboli 80 Mb/s. Frekvence, které hlava musí přenášet, se tak budou řádově pohybovat kolem 100 MHz, tedy frekvence FM rádia. Toto úzké hrdlo u SSD, které mají řádově desetinásobnou rychlost trvalého čtení, odpadá.
Příště uvidíme, co grep vygeneroval, a získáme hned několik literárních děl hledaného čtivého typu.
Nástroje: Tisk bez diskuse
Tiskni
Sdílej:


 22.9.2016 22:54
Jendа | skóre: 78
| blog: Jenda
| JO70FB
Při rychlosti disku 60 MB/s a 6 površích musí každá hlava zvládat 10 MB/s neboli 80 Mb/s.Opravdu disk umí držet na stopě všechny hlavy současně? Jsou na společném spindlu, ta mechanika by musela mít úžasnou reprodukovatelnost. Vždycky jsem si myslel (možná deformován historickým CHS systémem), že data jsou na disku lineárně.
 23.9.2016 09:20
David Ježek | skóre: 83
| blog: Mostly_IMDB

Takže na jedné straně … a na straně druhé …
Ve skutečnosti je úplně jedno, co je na jedné nebo druhé straně. I kdyby pod tou sérií byl podepsaný někdo, kdo dokázal tolik, co Linus Torvalds, Donald Knuth a Jim Starkey dohromady, bylo by mi to úplně jedno, protože ta série je dobrá leda k demonstraci toho, o čem je řeč v semináři ke hře Švestka: paradoxní kombinace neschopnosti udržet myšlenku a neschopnosti opustit myšlenku.
Já zvedám pracku pro více clocka a méně Kubečka
Na rozdíl od toho, kdo se za své názory stydí natolik, že se pod ně neodváží ani podepsat, si myslím, že existuje určitá úroveň, pod kterou by se klesnout nemělo. Takže na plnou… ústa: než vydávat tohle, raději nevydávat nic. A pokud by snad existence ABCLinuxu měla záviset na článcích jako tyhle, pak by to asi opravdu bylo lepší odpískat.
 26.9.2016 21:53
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
26.9.2016 22:45
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
27.9.2016 08:55
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
27.9.2016 11:07
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
27.9.2016 13:12
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
27.9.2016 14:49
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
27.9.2016 20:20
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
clanek si nasel spokojene ctenare, argo nemuze byt uplne spatny
To je hodně odvážná implikace - a zcela neoprávněná. Tato série článků není zdaleka jediným protipříkladem.
28.9.2016 14:26
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
jinou smysluplnou definici dobrého článku, než že si najde své spokojené čtenáře, neznámPodle teto definice nejlepsi clanky vychazeji v Blesku.
28.9.2016 15:41
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
leda by ses prohlasil za nadcloveka a zacal vnucovat svuj vkus jinym lidemna to jsou tu jini odbornici, ... kteri dokazou tak komplikovanou vec, jako je kvalita clanku, zredukovat na jednorozmernou dvouhodnotovou velicinu (ma ctenare/nema ctenare)
pripomina mi jednu piviedku od Lema kde Trurl zostrojil najhlupejsi stroj na svete a pokusal sa s nim hadat
 29.9.2016 08:54
Václav "Darm" Novák | skóre: 26
| blog: Darmovy_kecy
| Bechyně / Praha
29.9.2016 08:51
Václav "Darm" Novák | skóre: 26
| blog: Darmovy_kecy
| Bechyně / Praha
30.9.2016 10:02
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
argo nemuze byt uplne spatnyJako pes z cetnickych humoresek, Argo, uplne spatny nebyl. Termit, ktery jsi chtel pouzit, je tedy patrne "ergo".
28.9.2016 14:28
kyknos | skóre: 18
| blog: Quid novi?
| Ranša Rosa
29.9.2016 09:17
Jendа | skóre: 78
| blog: Jenda
| JO70FB
 29.9.2016 09:30
ʚĭɞ 🍉 | skóre: 94
| blog:
zdarma
Pane kolego, že vy používáte blokování reklamy?
 1.10.2016 13:16
Petr Tomášek | skóre: 39
| blog: Vejšplechty
A tenhle článek je spálený a přesolený?
Ano (v rámci té analogie). Nemluvě o tom, že to vlastně z větší části ani nejsou řízky, protože k údajnému tématu série se autor pořád ještě nedostal. :-)
Pokud by někdo zdarma rozdával řízky…
…tak to pořád ostatní nezbavuje práva hodnotit jejich kvalitu.
Loni jsem třeba na jedné konferenci dostal kabel s klasickým USB konektorem na jedné straně a mini- a mikro- na druhé. Když jsem pak zjistil, že se dá použít jen pro nabíjení, protože nemá propojené datové piny, musím si tuto informaci podle vaší logiky nechat pro sebe (a nechat ostatní, ať na to přijdou sami)?
29.9.2016 14:31
Jendа | skóre: 78
| blog: Jenda
| JO70FB
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz
