Programovací jazyk Python byl vydán v nové major verzi 3.15.0. Podrobný přehled novinek v aktualizované dokumentaci.
BIGWORDS.PAGE je open-source webová aplikace, která po otevření odkazu v prohlížeči vykreslí přes celou obrazovku jednoduché informační sdělení. Zpráva i její nastavení jsou uložené v části URL za znakem #, například odkaz https://bigwords.page/#abclinuxu zobrazí jako velký bílý nápis 'abclinuxu' na černém pozadí. Obsah odkazu lze upravovat i vestavěným editorem, ten umožňuje nastavovat formátování a vizuální efekty textu, časovače, QR kódy a obrázky. Zdrojový kód je dostupný pod licencí MIT na GitHubu.
V neděli 11. října proběhne rotace klíče kořenové zóny. Podruhé v historii. Ondřej Filip na blogu CZ.NIC: "Pokud je pro Vás DNS protokol spíše výzva, ale přesto spravujete nějakou síť či DNS resolver, zkuste si jednoduchý test, který připravila firma Cloudflare na této adrese. Obzvláště zbystřit byste měli, pokud uvidíte nějaká červená políčka."
Vláda Spojených států se rozhodla vyřadit americkou softwarovou společnost Microsoft a několik dalších velkých technologických podniků z programu, který umožňuje kvalifikovaným zahraničním pracovníkům získat povolení k trvalému pobytu. Oznámila to včera administrativa amerického prezidenta Donalda Trumpa. Opatření zdůvodnila rozsáhlým zneužíváním programu, který je dlouhodobě terčem kritiky ze strany Trumpových příznivců, neboť prý znevýhodňuje americké pracovníky.
Datové centrum největší ruské technologické společnosti Jandex v Rjazaňské oblasti se stalo cílem dronového útoku a zastavilo provoz. Jandexu se někdy přezdívá „ruský Google“. Provozuje nejoblíbenější internetový vyhledávač v Rusku nebo aplikace pro objednávky jídla a taxi. Využívají jej desítky milionů lidí v rusky mluvících zemích.
Francouzská společnost Mistral AI představila Mistral Large 4 (interně přezdívaný 'le Chonk', volně přeloženo 'pořádný macek'), 'open-weight multimodální hybridní instruct-and-reasoning model s architekturou granulárního MoE, nativně podporující více jak 160 jazyků'. Model má přes jeden bilión parametrů, z nichž při práci využívá 49 miliard, kontextové okno o délce milion tokenů a obrazový enkodér o 1,6 miliardách parametrů.
… více »Svobodný multiplatformní herní engine Bevy napsaný v Rustu byl vydán ve verzi 0.20. Díky 227 přispěvatelům.
Simon Long oznámil Raspberry Pi Desktop pro PC a Mac s Intelem postavený na aktualizovaném Debianu 13 Trixie. S klientem Raspberry Pi Connect pro vzdálenou správu. Ke stažení je vedle Raspberry Pi OS pro Raspberry Pi.
ESP32-C3 adblock přemění lacinou vývojovou desku ESP32‑C3 na samostatný DNS blokovač nejenom reklamních domén, minimalistickou alternativu k populárnímu Pi-hole. ESP32-C3 adblock místo objemných názvů domén ukládá jejich 40-bitové FNV-1a hashe do flash paměti, které pak binárně prohledává, kontrola jedné domény trvá přibližně 10 milisekund. Blocklist pojme až 537 tisíc domén a lze jej spravovat přes webové rozhraní. Projekt zatím
… více »ArtCraft je sada open source aplikací pro práci s obrázky a videi "inspirovaných" aplikacemi od Adobe. Napsaných v Rustu. Pro MacOS, Windows i Linux. Běží také ve webovém prohlížeči. Aktuálně se jedná o 7 aplikací: PhotoCraft (Photoshop), VectorCraft (Illustrator), FilmCraft (Premiere Pro), LightCraft (Lightroom), PdfCraft (Acrobat), EffectCraft (After Effects) a DesignCraft (InDesign). Zdrojové kódy jsou k dispozici na GitHubu.
Řešení dotazu:
 12.10.2013 10:24
Jendа | skóre: 78
| blog: Jenda
| JO70FB
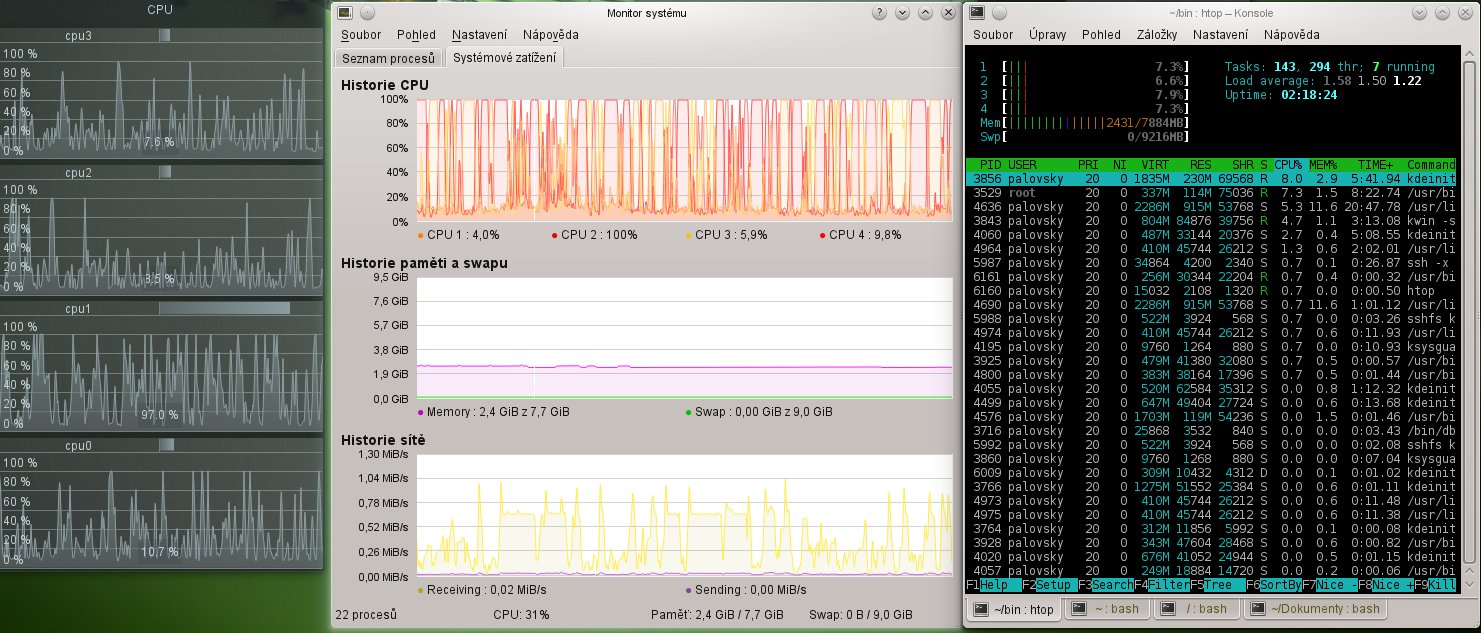
htop uvádí pro jednotlivá jádra naprosto jiné údaje o záteži. A samozřejmě takové, které nejdou vysvětlit libovolným přečíslováním jader.
Měřáky se berou z /proc/stat.
Zátěž není spojitá veličina, natož spojitě diferencovatelná. V daném časovém okamžiku je u jednoho procesoru vždy buď 0% nebo 100%. Tedy celkové zatížení systému například se 4 procesory je v daném okamžiku vždy přesně 0%, 25%, 50%, 75% nebo 100%.
Protože diferenciálně krátký okamžik je celkem nezajímavý a o ničem příliš nevypovídá, všechny utility zobrazují průměrnou zátěž za delší dobu. Jednoduše řečeno, odhadne se doba, kterou procesory strávily prací a kterou strávily nicneděláním. Zátěž je pak doba strávená prací během určitého časového intervalu dělená délkou tohoto intervalu. To například znamená, že pokud čtyři procesory strávily během jedné vteřiny dohromady 150% času prací, celková zátěž systému bude 150% / 400%, tedy 37,5%. Například mohly 3 z nich pracovat každý 50% času, případně všechny čtyři 37,5% času nebo třeba jeden na 100%, dva další na 25% a ten poslední během dané vteřiny nepracoval.
Odhad času, který procesory tráví prací, se dá provádět dvěma způsoby.
Primitivní způsob, který s několika modifikacemi používá Linux, využívá pravidelný tik hodin ke kontrole stavu procesorů. Když nachytá procesor při nicnedělání, zaznamená to. Když najde na procesoru běžící vlákno, přidá celý hodinový interval do časového účetnictví daného vlákna. Poté, co byl pravidelný hodinový tik odstraněn, bylo samozřejmě nezbytné postarat se o správné počítání času i na procesorech, které si dlouhodobě žádný timer nenaplánují. Nicméně hodnoty v souboru /proc/stat stále předstírají, jako by každý procesor zpracovával 100 tiků za vteřinu a u každého tiku zaznamenával aktuální stav. Odhad celkové zátěže je na Linuxu (nepřesně řečeno) tím přesnější, čím víc je procesorů, tedy například na 32-procesorovém stroji přibude do první řádky /proc/stat celkově 3200 tiků každou vteřinu, zatímco na dvouprocesoru pouze 200 tiků.
Tento jednoduchý způsob má samozřejmě své chyby, protože vlákno ve skutečnosti může běžet po dobu mnohem kratší než doba mezi tiky hodin, ať už kvůli vypršení plánovacího kvanta, kvůli migraci na jiný procesor nebo kvůli uspání z velmi široké škály možných důvodů. Idea je ovšem taková, že i přes drobné nepřesnosti bude v průměru a z dlouhodobého hlediska účtování času korektní, tedy pravděpodobnost výrazných systematických odchylek je z pohledu statistiky velmi malá.
Přesnější, ale náročnější způsob účtování času má například Solaris (Illumos, OpenIndiana) a AIX. V těchto systémech se při každé změně stavu procesoru explicitně přečte vhodný nanosekundový čas (tj. časomíra s velkým rozlišením, kterou většina moderních platforem implementuje) a na základě tohoto času se pak přesně počítá, jak dlouho byl procesor v userspace, jak dlouho byl v systému, jak dlouho obsluhoval interrupty, jak dlouho provozoval virtuální stroje — každý interval mezi dvěma sousedními změnami stavu se dá zaúčtovat velmi přesně. V Solarisu se to jmenuje microstate accounting. Tohle ovšem s sebou nese vysokou daň v podobě doby potřebné pro přečtení přesného času. Jakkoliv se to může zdát překvapivé, čtení přesného času je drahé a odpovídá desítkám až stovkám aritmetických instrukcí. (Důvodem je, že se zpravidla jedná o čítač tiků procesoru, který musí fungovat jako pipeline, protože inkrementace čítače se obecně nedá realizovat v jednom tiku. Čtení čítače vyžaduje čekání na dosažení definovaného a čitelného stavu a navíc různá opatření, která kompenzují vliv čtení na rychlost postupu čítače.) Jestliže se tedy například Linux chlubí, že přerušení dělí od příslušného handleru pouze 18 instrukcí (což se člověk dočte ve slavné zprávě „Have you ever kissed a girl?“; dnes už to bude zcela jistě úplně jinak), přidání přesného časovače by mohlo způsobit za jistých okolností zhoršení výkonnosti. (Dlužno připomenout například registrová okénka na platformě SPARC, o jejichž správu a přepínání se musí postarat kernel, když na to přijde, a může na to přijít velmi často.) (Jakmile ovšem musí handler přerušení sáhnout kamkoliv do paměti, která není zrovna v lokální cache na procesoru, cena takového přístupu odpovídá stovkám až tisícům aritmetických instrukcí, takže zůstává otázkou, jak moc velký negativní vliv vlastně microstate accounting má.)
Ať už je způsob měření času jakýkoliv, vždy nakonec dojde na průměrování přes delší časový úsek. Právě volba tohoto delšího časového úseku vede k různým výsledkům pro různé utility. Například průměr za dobu jedné minuty by jistě všechny utility vypočítaly téměř stejně. Jenže tento průměr příliš nevypovídá o změnách zátěže během té minuty. Naopak průměr za sto milisekund velmi rychle (z lidského hlediska) reaguje na změny zátěže, ale potíž je v tom, že je extrémně nestabilní a těžko se z něj (pouhým okem) odhaduje nějaký průměr nebo trend.
Monitorovací utilita v KDE (ksysguard) implicitně vykresluje zátěž pro každý procesor zvlášť. Ta bude samozřejmě mnohem méně stabilní než celkový průměr. Často bude některý z procesorů pravidelně skákat na 100%, protože například zrovna zpracovává data související s šifrováním filesystémů, SSH, VPN, dekódováním hudby a tak podobně, zatímco ostatní procesory budou častěji idle. Tedy to, co vidíš na tom screenshotu, je naprosto normální. V ksysguard si lze u každého sešitu nastavit interval měření, tedy ten interval, přes který se zátěž průměruje. Pak bude vidět, že dlouhý interval produkuje pěkný hladký průběh, ale neukazuje rychlé fluktuace zátěže, zatímco pro krátký interval platí přesný opak. Je méně stabilní, ale změny zátěže (i krátkodobé) jsou hned vidět. Tedy je to věc jakéhosi kompromisu.
Lepší způsob výpočtu zátěže (je-li třeba odhad zátěže aktualizovat často a nepravidelně) je založený na exponenciálním klouzavém průměru, jehož vzorec se trochu poupraví pro „práci se zlomky“ (extrémně vágně řečeno). Výhodou takového postupu je absence pravidelného intervalu, který by přinášel nestabilitu, a možnost aktualizovat odhad zátěže libovolně často. Nicméně i klouzavý průměr potřebuje předem znát konstantu, která představuje kompromis mezi rychlou odezvou na změnu zátěže a stabilitou hlášených hodnot. Nepřítomnost předělů mezi časovými intervaly s sebou ovšem nese jistou daň v podobě malého rezidua z minulosti, bez kterého by ovšem odhad neměl „hladší“ průběh. Pokud vím, současné utility pro měření zátěže klouzavé průměry nepoužívají. Použil jsem tuto techniku v projektech, u kterých byl hladký a zároveň přijatelně přesný odhad zátěže velmi důležitý a kde nebylo žádoucí měřit zátěž v předem daných pravidelných intervalech.
Sečteno a podtrženo, zátěž není žádná přesná a spojitá veličina; je to něco, co se dá mnoha různými způsoby definovat, mnoha různými způsoby měřit a odhadovat. Proto dává každý měřák jiné hodnoty.
 16.10.2013 17:34
rADOn | skóre: 44
| blog: bloK
| Praha
Tiskni
Sdílej:


 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz