Počítačová hra Factorio (Wikipedie) nově běží nativně na ARM64 Linuxu a headsetu Steam Frame.
Fugleramme, v překladu 'ptačí rámeček', je open-source projekt postavený na Raspberry Pi, který pomocí lokální umělé inteligence BirdNET-Go rozpoznává ptačí druhy podle jejich zpěvu a na displeji následně zobrazuje koláž tvořenou odpovídajícími ilustracemi. Databáze obsahuje přes 800 ručně vybraných historických přírodovědných ilustrací více než 400 druhů ptáků.
… více »Unicode Consortium, nezisková organizace koordinující rozvoj standardu Unicode, oznámila vydání Unicode 18.0. Přidáno bylo 13 007 nových znaků. Celkově jich je 172 808. Přibylo 9 nových Emoji.
Nové číslo časopisu Raspberry Pi zdarma ke čtení: Raspberry Pi Official Magazine 169 (pdf).
Byla vydána nová verze 6.4 programovacího jazyka Swift (Wikipedie). Zdrojové kódy jsou k dispozici na GitHubu.
Německý kancléř Friedrich Merz (CDU) se během debaty s finalisty studentské vědecké soutěže Jugend forscht vyjádřil pro konec anonymity na internetu a vyslovil názor, že pro uživatele Internetu by měla platit podobná právní odpovědnost jako pro novináře tradičních médií. Na dotaz studenta, jak by se tedy povinnost uvádět pravé jméno slučovala s prací investigativních novinářů nebo ochranou jejich zdrojů, Merz neodpověděl, ve své
… více »Společnost Fujitsu představila FUJITSU-MONAKA CPU a Fujitsu MONAKA Server. Navrženo, vyvinuto a vyrobeno v Japonsku. Pro suverénní AI infrastrukturu.
Předprodej v květnu představených notebooků Googlebook, nástupců notebooků Chromebook, bude spuštěn v pondělí 21. září.
Byla vydána betaverze Fedora Linuxu 45 (ChangeSet), tj. poslední zastávka před vydáním finální verze, která je naplánována na úterý 20. října. S konzolí kmscon místo fbcon. Současně byla vydána betaverze Fedora Linux Asahi Remixu 45. S podporou čipů M3.
Po půl roce vývoje od vydání verze 50 bylo vydáno GNOME 51 s kódovým názvem "A Coruña" (Mastodon). Podrobný přehled novinek i s náhledy v poznámkách k vydání a v novinkách pro vývojáře. Videopředstavení na PeerTube a YouTube.
Některé programy, které vyvíjíme (Fotomon, Měření) , používají množství různé statistiky. Moje chápání statistiky je spíše klasické, ale existuje ještě jiný pohled na statistiku - Bayesiánská statistika. Rozhodl jsem se jí porozumět a naučit se ji prakticky používat.
Moje první kroky vedly na Wikipedii:
http://cs.wikipedia.org/wiki/Bayesova_věta
Našel jsem tam přesně to, co jsem čekal: matematický formalismus, pod kterým si nedovedu nic představit (pravděpodobnost, že na Wikipedii najdu to, co hledám, ve formě stravitelné pro průměrného inženýra, už dnes dovedu pomocí bayesiánské statistiky docela dobře odhadnout). Ale je tam odkaz:
http://cs.wikipedia.org/wiki/Bayesovská_statistika
Je tam příklad. Skvělé! Ale kdo tohle psal!? Velmi volně cituji:
Test na nemoc dá kladnou odpověď u 99% nemocných pacientů a u 5% zdravých pacientů. Nemocí trpí jen 0.1% populace. Jaká je pravděpodobnost?
He? WTF? Jaká pravděpodobnost? Co se po mě chce? Pravděpodobnost čeho? No nic, třeba to vyplyne z textu dále:
"Pravděpodobnost choroby je o 19% větší, než u těch, kdo se testu nepodrobili."
No nazdar, máme zde další skupinu: přibyli nám ještě netestovaní. Kam si je mám zařadit? Navíc to je formulováno tak nešťastně, že kdybych nevěděl, jak veliký je to nesmysl, mohl bych usuzovat, že provedení testu nějak ovliní, jestli člověk onemocní, nebo zůstane zdravý.
Jsem ztracen.
Několikrát jsem narazil na příklad s dvěma pytlíky s bílými a černými kuličkami, což mi celou problematiku ještě více zatemnilo. Tuhle míchanici současné a předchozí pravděpodobnosti, střídaní minulosti, přítomnosti a budoucno také nedokázal nikdo dostatečně jasně vysvětlit. Popis primitivní úlohy na tři listy formátu A4 zvyšuje WTF faktor nade všechny meze.
Začal jsem hledat v angličtině. Odfiltroval jsem všechny kuličky v pytlíku a nakonec jsem skvělý příklad objevil zde:
http://people.hofstra.edu/Stefan_Waner/RealWorld/tutorialsf3/frames6_6.html
Konečně mi docvaklo. Celý ten Bayesův vzorec je obyčejná trojčlenka. To mi mohli vysvětlit už v prváku na střední a nemusí se z toho dělat zbytečná věda. Jakmile jsem si to namaloval a pochopil, vypadá základ bayesovské statistiky prostince:
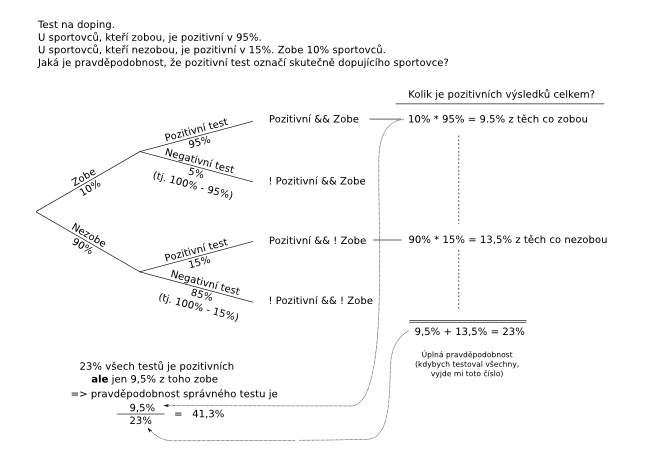
Pro praktické použití je třeba ještě pochopit jednu věc: bayesiánský vzorec je často uváděn ve zjednodušené formě a není jasné, jak z něj spočítat například toto:
Ve jmenovateli (část zlomku pod čarou) Bayesova vzorce figuruje takzvaná "úplná pravděpodobnost". V příkladu dopujících a nedopujících sportovců je to součet všech pozitivních výsledků, tj. 9,5% + 13,5%. V případě tří fabrik je to:
Sečteme jednotlivá procenta: celkem 2,9% ze všech výrobků na trhu jsou zmetky. Z fabriky A jich pochází: 50% * 2% / 2,9% = 34,4%
(Příklad jsem nalezl v dokumentu, který nyní není dostupný, googlujte "Bayes Krčková").
Možnost použít libovolný počet různých vstupních parametrů (zde fabriky A, B a C) je dobrá zpráva pro praktické použití v programech - dovoluje to snadno dekomponovat problém na několik samostatných částí.
Jakmile jsem pochopil princip, došlo mi, že bayesiánská statistika není nic složitého či nepochopitelného. Zkuste si to. Namalujte si třeba dva pytlíky s kuličkami - uvidíte sami.
Tiskni
Sdílej:


Moje chápání statistiky je spíše klasické, ale existuje ještě jiný pohled na statistiku - Bayesiánská statistika.
WtF?
Nicméně, je jasné, že různé pohledy na statistiku nemohou nic změnit na platnosti Bayosova vzorce. Tj. i "frekventisté" platnost Bayosova vzorce samozřejmě uznávají.Presne tak, pokud tomu rozumim, tak rozdil mezi 'frekventistickou' a 'bayesovskou' interpretaci pravdepodobnosti je ciste zalezitost interpretacni, na vzorce a vysledky to nema vliv (podobne jako ruzne interpretace kvantove mechaniky). Proto je treba nemichat 'bayesovskou interpretaci' na jedne strane a bayesuv vzorec ci bayesovskouu inferenci, coz jsou elementarni veci z pravdepodobnosti a statistiky platne a pouzivane nezavisle na interpretaci.
 16.4.2014 21:59
=^..^= AmigaPower® | skóre: 30
| blog: BLB
| Praha
 14.4.2014 09:09
Petr Bravenec | skóre: 43
| blog: Bravenec
14.4.2014 13:01
Petr Bravenec | skóre: 43
| blog: Bravenec
 14.4.2014 13:52
Bystroushaak | skóre: 36
| blog: Bystroushaakův blog
| Praha
14.4.2014 21:50
Petr Bravenec | skóre: 43
| blog: Bravenec
15.4.2014 13:35
Petr Bravenec | skóre: 43
| blog: Bravenec
15.4.2014 06:21
Petr Bravenec | skóre: 43
| blog: Bravenec
17.4.2014 09:49
Petr Bravenec | skóre: 43
| blog: Bravenec
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz

 14.4.2014 13:04
 Ale jiz jsem o tom zde psal, kdo hleda, najde.