Oficiální Epic Games Launcher je v nové preview verzi poprvé dostupný i pro Linux (FAQ). Pracuje se na novém Easy Anti-Cheatu pro Linux (EAC Linux v2) a podpoře hry Fortnite na Linuxu.
Desktopové prostředí KDE Plasma bylo vydáno ve verzi 6.8. Novinky zahrnují lepší podporu vzdálené plochy, sdílení a nahrávání obrazovky a řadu drobností napříč uživatelským rozhraním (úplný seznam změn, shrnutí ve wiki).
Apple představil 7palcový displej Apple HomeView s podporou Apple Intelligence a Siri AI pro ovládání chytré domácnosti, novou řadu vybavení chytré domácnosti Apple Home Collection, další generaci HomePodu mini a novou Apple TV 4K. Apple HomeView není v Evropské unii v prodeji, jelikož umělá inteligence Siri v rámci systému iOS v EU momentálně není k dispozici. Apple spolupracuje s EU a snaží se najít cestu, jak situaci vyřešit.
KDE slaví 30 let. Přesně před 30 lety, 14. října 1996, poslal Matthias Ettrich do diskusní skupiny comp.os.linux.misc zprávu, která započala historii projektu KDE. Důležité milníky jsou zobrazeny na časové ose.
Byl vydán Mozilla Firefox 158.0. Stejně jako Chrome 155 s podporou JPEG XL (test). Přehled novinek v poznámkách k vydání a poznámkách k vydání pro vývojáře. Řešeny jsou rovněž bezpečnostní chyby. Nový Firefox 158 bude brzy k dispozici také na Flathubu a Snapcraftu.
Svobodný kancelářský balík ONLYOFFICE (Wikipedie) byl vydán ve verzi 10.0. Jak online Docs, tak i offline Desktop Editors. Přehled novinek také na YouTube.
Mozilla představuje Firefox Enterprise určený jako podnikový prohlížeč pro organizace s přísnými požadavky na bezpečnost, správu a dodržování předpisů. S profesionální podporou. Dostupný je zatím ve Francii, Německu, Rakousku a Švýcarsku.
Kybernetický útok zasáhl nejméně 150 supermarketů Intermarché a několik prodejen řetězců Leclerc a Coopérative U. Chladicí jednotky napadených obchodních domů byly nastaveny na nepřetržité odmrazování a teplota v nich mnohdy vystouala až nad 50°C. Škody napáchané na chlazeném a mraženém zboží budou patrně dosahovat miliónů eur.
… více »Stát Kalifornie zažaloval výrobce 3D tiskových filamentů Polymaker. Vrchní soud San Diego County tvrdí, že firma propagací svých výrobků mezi příznivci 3D tištěných zbraní podporovala výrobu takzvaných 'ghost guns' (DIY zbraní) a že její PLA filament pro 3D tiskárny lze za těchto okolností považovat za součást určenou k výrobě střelné zbraně. Žaloba požaduje mimo jiné finanční sankce a soudní zákaz činnosti, Polymaker se hájí tím, že filament je běžný a sám o sobě legální produkt. Celý text žaloby (PDF na Google Drive).
V červnu byla představena aplikace Myna pro převod řeči na text v prostředí desktopu Ubuntu. Včera byla Myna zpřístupněna širší komunitě Ubuntu formou technologické ukázky dostupné v Ubuntu 24.04 LTS, Ubuntu 26.04 LTS a Ubuntu 26.10 s GNOME na Waylandu.
Sťahovací bot začína sťahovať nejakou úvodnou stránkou a všetky vyhovujúce odkazy pridá do zoznamu URL na indexovanie (pokiaľ nie je už priradená na indexovanie alebo už nebola stiahnutá). Typ zoznám URL na indexovanie je FIFO. Sťahovanie skončí ak zoznám URL na indexovanie nemá žiadnu položku na sťahovanie.
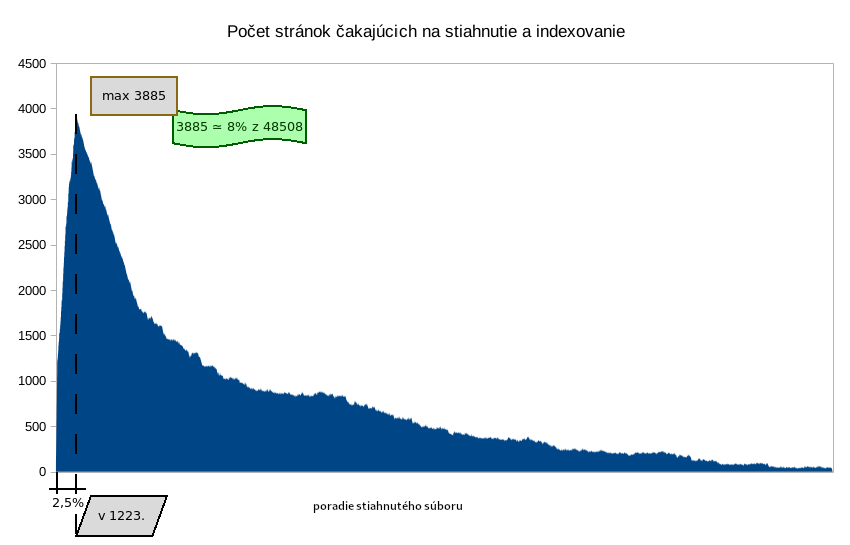
Oprava 2) - zoznamu URL na indexovanie bol v skutocnosti FIFO a nie LIFO.
Tiskni
Sdílej:


wgetříká se tomu rekurzivní stahování a umí to i třeba wgetAno, ale dokaze len urcitu url (trebars podla regularneho vyrazu) a dokaze ak, dam viac naraz stahovat priradit pre kazdu URL vlastny nazov?
mícháš dohromady velikost jedné stránky a počet stránek ke staženíSlovo vela sa mysli ak to pouzivam ako mnoho (napr. V skupine je vela /ako mnozstvo/ muzov. A potom v skupine je vela velkych /ako mohutnych/ muzov). Prepisal som to na lepsie.
indexování znamená sestavování (databázového) indexu, ty to jen stahuješ a přímo zpracováváš/cachuješAko sa to vezme - zaindexuje to vyhlavac (stiahne si kopiu). Mozno priamo nie je mojim zamerom indexovanie, ale aj tak to robim. Stahujem vsetky temy. Cize mam index vsetkych tem fora na stranke. Ale jasne, indexujem aj stiahnutu stranku, lebo aj tam mozu byt odkaci (co na tej konkretnej aj stranke boli - widget "Podobne temy").Ale indexujem iba co ma zaujima. Napr. vyhlavac na obrazky nebude predsa spracuvavat mp3.
 30.8.2020 21:12
Bystroushaak | skóre: 36
| blog: Bystroushaakův blog
| Praha
Ano, ale dokaze len urcitu url (trebars podla regularneho vyrazu) a dokaze ak, dam viac naraz stahovat priradit pre kazdu URL vlastny nazov?Dokáže stahovat podle regexpu, včetně blacklistů a whitelistů. Nevím co je přiřadit pro každou URL vlastní název. Ukládá to na disk podle názvu / cesty a možná umí i nějaké další vymyšleniny. Na paralelní stahování je afaik lepší aria2.
Ako sa to vezme - zaindexuje to vyhlavac (stiahne si kopiu). Mozno priamo nie je mojim zamerom indexovanie, ale aj tak to robim. Stahujem vsetky temy. Cize mam index vsetkych tem fora na stranke. Ale jasne, indexujem aj stiahnutu stranku, lebo aj tam mozu byt odkaci (co na tej konkretnej aj stranke boli - widget "Podobne temy").Ale indexujem iba co ma zaujima. Napr. vyhlavac na obrazky nebude predsa spracuvavat mp3.Imho ta terminologie pochází z toho že dřív než vyhledávače byly na světě indexy; stránky které fungovaly jako rozcestníky se spoustou kategorií (lycos?). Když se přidávala nová stránka, jednalo se o indexování; akt přidávání do indexu. Pak přišly vyhledávače a prostě už se tomu tak říkalo, protože se pořád přidávaly stránky do indexu, i když automaticky. To co děláš ty je prostě jen rekurzivní stažení webu, které technicky vzato fakt s indexováním nemá nic společného, ale whatever, imho není úplně terminologicky špatné to takhle nazývat.
Nevím co je přiřadit pro každou URL vlastní název.Myslel som toto. Priklad je pre 1 subor.
wget https://www.abclinuxu.cz/blog/analyza_greenie_20_04/2020/8/ako-dlho-bude-trvat-indexovanie-stranok -O https:__www.abclinuxu.cz_blog_analyza_greenie_20_04_2020_8_ako-dlho-bude-trvat-indexovanie-stranok
30.8.2020 21:45
Bystroushaak | skóre: 36
| blog: Bystroushaakův blog
| Praha
blog/analyza_greenie_20_04/2020/8/ako-dlho-bude-trvat-indexovanie-stranok. Tedy do podsložek (jde to afaik vypnout).
30.8.2020 22:04
Bystroushaak | skóre: 36
| blog: Bystroushaakův blog
| Praha
Ano, ale dokaze len urcitu url (trebars podla regularneho vyrazu) a dokaze ak, dam viac naraz stahovat priradit pre kazdu URL vlastny nazov?Dokáže stáhnout stránku, sesbírat z ní odkazy a ty pak rekurzivně procházet. Proto se tomu říká rekurzivní stahování a ne typ sťahovania sťahovanie webovej stránky/domény s množstvom stránok, ani stahování velikostí stránek, nebo co jsi to tam měl původně.
Slovo vela sa mysli ak to pouzivam ako mnoho (napr. V skupine je vela /ako mnozstvo/ muzov. A potom v skupine je vela velkych /ako mohutnych/ muzov). Prepisal som to na lepsie.Já vím, co znamená slovo vela, ale nevím, jak to souvisí.
Ako sa to vezme - zaindexuje to vyhlavac (stiahne si kopiu).1. Ty píšeš vyhledáváč? 2. Stažení kopie není totéž co indexování.
Mozno priamo nie je mojim zamerom indexovanie, ale aj tak to robim.Jakou používáš databázi? Jak je nakonfigurovaná? Na jakém hardwaru běží? Abych se z toho článku tedy dozvěděl, jak dlouho ti to indexování trvá…
Ale jasne, indexujem aj stiahnutu stranku, lebo aj tam mozu byt odkaci (co na tej konkretnej aj stranke boli - widget "Podobne temy").Říkej si tomu jak chceš, ale mimo tvojí hlavu to nebude dávat smysl, protože indexování všude jinde znamená něco jiného.
Jakou používáš databázi? Jak je nakonfigurovaná? Na jakém hardwaru běží? Abych se z toho článku tedy dozvěděl, jak dlouho ti to indexování trvá…Ziadny databaza a la MySql or PostgreSQL. Vlastne riesenie. V rozsahu do radu 10k v pohode. Odvtedy mam kod uz upraveny a prakticky funkcny na 1M. Limitom pri takej indexacie je najma stiahnutie zo servera. 1M chce CPU 0.9GHz. Mas uvedene celkovy pocet. Daj cez wget stiahnut a mas +- minimalne, kolko to bude trvat. Konkretne v pripade linuxforum.hu to bolo od 20.08 00:52 do 22.08 22:44.
Říkej si tomu jak chceš, ale mimo tvojí hlavu to nebude dávat smysl, protože indexování všude jinde znamená něco jiného.Uzytok vysledneho grafu je najme pre indexovanie, kde pod pojmom indexovanie sa chape poznanie stromovej URL struktury na stranke.
30.8.2020 21:13
Bystroushaak | skóre: 36
| blog: Bystroushaakův blog
| Praha
wgetu jsem stahoval nějaký web (asi AbcL), a než jsem si toho všiml, vyprodukoval miliony souborů a adresářů (to opravdu nechcete mazat), protože našel odkaz na stránce adresa s číslem, který vede na adresa s číslem + 1. FIFO v téhle situaci bude sice stahovat do nekonečna, ale stihne před zacyklením stáhnout celkem smysluplnou část webu. LIFO by zůstal ve smyčce při první takové stránce. Chtělo by to detekci počítadla v URL nebo příliš podobných stránek. V případě, že nekonečné stahování nevadí, dává celkem smysl volit stránku ke stažení náhodně s pravděpodobností stažení rostoucí s její významností, což může být metrika založená na počtu stránek, které na ní odkazují, nebo na minimálním/průměrném počtu odkazů, které se musí projít než se na ní dostane z hlavní stránky.
 31.8.2020 13:07
Josef Kufner | skóre: 70
Pozor na nekonečné smyčkyObaval som sa toho, ale realne ziadna nenastala. Proste pri indexovany overujem URL ci uz bola indexovana.
ČasováníBral som ohlad aj na druhu stranu. Testoval som, kym som najprv stahoval. A v user agent posielam svoj mail, ak by im to nieco vadilo.
From?
§ 5.5.1 The "From" header field contains an Internet email address for a human user who controls the requesting user agent. […] A robotic user agent SHOULD send a valid From header field so that the person responsible for running the robot can be contacted if problems occur on servers, such as if the robot is sending excessive, unwanted, or invalid requests.
Mozilla/5.0 (compatible; NetcraftSurveyAgent/1.0; +info@netcraft.com)
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz


