Výzkumníci ukazují, jak mohou otevřené tunely a IPv6 Extension Headers synchronizovat pakety do krátkých provozních špiček. V kontrolovaném experimentu naměřili přes 180násobnou koncentraci paketového toku vůči průměrné rychlosti odesílání — nikoli 180násobné zvětšení objemu dat. Článek obsahuje metodiku, limity měření i mitigace pro GRE, IPIP a další tunely.
Po velkém úspěchu prvního MobileLinux Hackdaye se vracíme do Českých Budějovic s druhým ročníkem. V pátek 30. října 2026 od 10:00 se v prostorách Jihočeské univerzity uskuteční Embedded & MobileLinux Hackday #2. Těšit se můžete na témata jako Immutable Linux na telefonech (BengalOS), U-Boot a upstream vývoj, AI optimalizace pro embedded systémy nebo otevřený hardware. Nebude chybět praktické hackování, sdílení zkušeností a možnost … více »
Dne 21. října 2026 vydal projekt Node.js bezpečnostní aktualizace opravující deset zranitelností, včetně jedné umožňující potenciální vzdálené spuštění kódu (RCE). Nejzajímavější je CVE-2026-111497, chyba dekodéru Brotli, kterou objevili výzkumníci využívající OpenAI Codex Security. Chyba je v nativním dekodéru Brotli, nikoli v samotném JavaScriptu. Speciálně vytvořený komprimovaný vstup způsobí, že dekodér zamění
… více »Francouzský výrobce kabelů Nexans upozornil na napjaté dodávky elektrických kabelů. Výstavba nové výrobní linky pro některé typy kabelů může trvat přibližně tři roky. Datacentra potřebují rozsáhlé nízkonapěťové a středněnapěťové rozvody. Poptávka roste současně s modernizací elektrických sítí. Někteří odběratelé proto uzavírají výrazně delší dodavatelské smlouvy [Reuters].
Představena byla (𝕏) virtuální platforma FLYBENCH FPV, která nováčky provede zapojením a konstrukcí dronů.
Google Chrome 156 byl prohlášen za stabilní. Přehled novinek v poznámkách k vydání. Opraveno bylo 353 bezpečnostních chyb. Vylepšeny byly také nástroje pro vývojáře.
Indická společnost eMudhra po bezpečnostním incidentu, tj. kompromitaci soukromých klíčů osmi mezilehlých certifikátů své certifikační autority, opouští globální byznys s SSL/TLS certifikáty.
Dle Phoronixu zveřejnila společnost Trend Micro prostřednictvím programu Zero Day Initiative (ZDI) několik hlášení bezpečnostních zranitelností přímo na veřejném mailing listu LKML, přestože některé chyby dosud nemají opravu začleněnou do hlavní větve jádra. Mezi hlášenými problémy jsou dvě zranitelnosti s hodnocením CVSS 9.0, týkající se SMB Direct a KSMBD, které mohou umožnit vzdálené spuštění kódu. Další hlášení se týkají … více »
Správce hesel KeePassXC byl vydán ve verzi 2.8.0. Přechází na Qt 6, podporuje vkládání hesel s Waylandem, rychlé odemykání pomocí Polkitu nebo možnost nastavení klávesových zkratek (seznam změn).
Databáze DuckDB (Wikipedie) byla vydána ve verzi 2.0.0 LTS. S kódovým názvem Cinnamon Teal (čírka skořicová). S vyladěným protokolem Quack.
A?
Takhle nějaký vzoreček na ukázku by nebyl? Abychom měli představu z čeho co vykouzlí a kolik dalšího sraní to pak ještě bude vyžadovat.
Ale je to AI, tak to musí být určitě lepší, ne? 
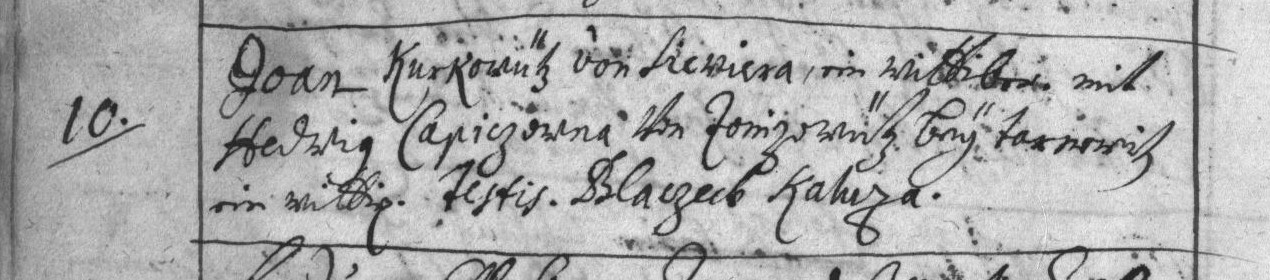
Pro mne to začne být zajímavé, až to zvládne i texty, jako je kupř. ten v příloze.

Běžný matriční záznam ze 17. století: 10. Junnius 1674 Joan Kurkowűts von [Li]ewiera, ein Wittiber mit Hedwig Capiczowna Won [J]omzowűtz beӳ Tarnowitz ein Wittib. Testis. Blaczech Kaluza. – link na originál.
Moje interpretace: 10.6.1674 [se oženil] Jan Kurkovic, z ?, vdovec (ein Wittiber) s (mit) Hedvikou, dcerou Kapicy (použití přípony -owna dokládá polský původ) z ? poblíž (bei) Tarnovic, vdovou (ein Wittib). Svědci (Testis) Plaček Kaluža.
Problém tohoto záznamu: Nejsem schopen blíže identifikovat obce ze kterých pocházeli. Tarnovice, od dob Jana Lucemburského patřící mezi země české koruny, jsou dnešní Tarnowskie Góry. V roce 1674 ještě pod legitimní vládou korunovaného (1656) českého krále Leopolda I. Habsburského. V oblasti, kterou si o 66 let později přivlastnilo Prusko (1740) a kterou roku 1922 rada Společnosti národů (takový předchůdce NATO, kde hrála prim Francie a Velká Británie) přiklepla obnovenému vazalskému Polsku, přestože si na ni brousilo zuby vazalské Československo (které by si tak interně vylepšilo poměr slovanů vůči germánům). Ale to je celkem fuk, protože dál do minulosti se už přes matriky stejně nedostanu. Starší záznamy (v češtině) (1654) jsou ještě stručnější. Který čech by se obtěžoval takovým detailem, jakým bylo jméno ženy 8-P, hlavně že to má datum.
Tak to si zřejmě ucvrnkneš štěstím, až tu po volbách zavládnou pořádky slovenského premiéra, když už ne tedy rovnou šéfredaktora. O přísloví „poturčenec horší turka” jsi slyšel?
No. Bez ruční práce to nepůjde, ale zefektivnit asi jo.
Každá slušná kniha obsahuje tiráž. Pokud máš mobil, který alespoň trochu slušně fotí, tak ber jednu po druhé na nacvakej si do něj ty tiráže. ALE JEN TIRÁŽ – tzn. že na té fotce bude jen tisk a bílé pozadí.
Ber polici po polici, ale systematicky.
Až s tím budeš hotov, přesuň ty fotky do kompu a můžeš na to poštvat netpbm. Abys neřekl, tady máš kolonu, kterou na to můžeš použít:
~# ${JPEGTOPNM} ${SOURCE} | \
   ${PAMCUT} -left 150 -width 1 | \
   ${PAMTOPNM} | \
   ${PPMTOPGM} | \
   ${PGMTOPBM} -threshold -value 0.5 > /tmp/strip.pbm
A na ten hotový soubor /tmp/strip.pbm poštvi tesseract a výstup ulož do souboru, pojmenovaného stejně jako ten snímek tiráže, akorát s příponou .txt. Výchozí soubor (snímek) ti poskytne přes exif čas pořízení snímku, který pak můžeš do těch souborů přidat.
A máš v podstatě k dispozici vše k tomu, abys mohl vygenerovat katalog a k němu adekvátní štítky s QR kódy, kterýma pak olepíš hřbety, ev. titulní listy těch knih.
Jak jsem napsal hned úvodem. Bez ruční práce se to neobejde a každou z těch knih budeš muset vzít minimálně jednou do ruky. Ale pak, až to budeš mít v těch textových souborech, už půjde hodně věcí automatizovat.
Ten čas je důležitý – pomůže ti setřídit ty soubory podle umístění knihy. Na konci police si cvakni třeba její číslo, nebo alespoň prázdný list. Pomůže ti to detekovat začátky a konce číselných řad.
A polepením je dobré pověřit nějakou pečlivou osobu, co nesere na to co dělá. Nemusí být moc chytrá ani zručná. Jenom by měla průběžně kontrolovat jestli lepí správný štítek do správné knihy.

Tak to si počkej až cbrpnk natrénuje tu Ollamu. Obávám se však, že do té doby zemřeš úderem do hlavy o ten regál, když si přišlápneš vous, co ti za tu dobu vyraší 8-D
ta tva predstava je stejne detinska jako kdyz muj 8 lety syn ma predstavu ze bude bydlet s nama i kdyz mu bude 30 let...Aby ses nedivil, zrovna mama-hotel ve třiceti je dnes celkem běžná věc.
Ochraptíš u prvního regálu. Nehledě na to, že ten "text2speech tool" si také schroustne nějaký ten čas a výpočetní výkon. Já na taková nástroj čekal přes 20 let, protože nebyl kdo by to za nějaký obolus překepal na stroji. A ta kvalita stejně není nic moc a vyžaduje korekci.
Chceš knížecí radu?
Zapomeň na rychlá řešení a začni něco dělat. Půjde to pomalu, ale jistě. Když počítáš na jednu knihu optimistických 30 sekund, tak s tím zabiješ 7 člověkodní při počtu 20 tis. publikací, a tolik jich tvá babi za svůj život nenastřádala. To se vsadím. Sám jich vlastním odhadem něco do tisícovky, včetně knihovny co jsem zdědil po bratranci, co byl podobný knihomol jako já.
Nedostatky tohoto řešení zmínil už Žako. Krom toho, tituly na hřbetu knih nejsou ani zdaleka samozřejmostí. Polovina knih co vlastním je nemá a mnoho jich ani nemá tiráž - samizdaty, archiválie, či hodně jeté rarity ulovené z antikvariátů.
Vím, že se opakuji, ale jsou oblasti na které AI nemá a nikdy mít nebude. Těžko ti najde knihu na základě pocitu a jen velice vágní vzpomínky na to co jsi kdysi dávno četl. Neví nic o tom, jak ra kniha byla velká, ani kde se přibližně ta pasáž nalézá. Takový Techický slovník Teyslerra Kotyšky má přes metr, ale také index. Ovšem mraky jiných knih nic takového nemají a přesto vím kde najdu založeno to co hledám.
reknu jednoduseji - mne nezajima, jak to nejde a proc to nejde.
Ale mělo by, příteli. Mělo by. Marně se neříká „dvakrát měř a jednou řež”. To máme u nás také jednoho takového, kterého to nezajímá, a pak se hrozně diví, kam až klesá priorita jeho požadavků.
Nemusíš se hnedka čertit. Tesseract není žádná AI, pracuje s hotovými modely které si musíš stáhnout, podle toho o jaký jazyk půjde. Umí zpracovat i frakturu, pokud máš ten správný model (tesseract-ocr-frk). Ale jsou prostě texty pro které žádný model není a nebude. Jako ten, který jsem uvedl.
K jejich vyluštění je totiž potřeba mraky jiných, zdánlivě nesouvisejících informací i jistou dávku intuice, kterou AI nemá.
Nechápu, proč se vždy stavíš proti všem do opozice.
To se ti jen zdá. Já jsem spočítal, kolik by mu asi tak zabralo zpracování tiráží. A když jsem odpovídal, šlo primárně o bezprostřední reakci na ten jeho šílený nápad – „to uz radsi si sednout a nahlas cist nazvy knih do mobilu azvukove soubory pak prehnat pres nejaky text2speech tool. akorat to by potrebovala nejakeho cloveka, co se mluvenim zivy, protoze cele hodiny cist (artikulovane, s durazem na cistotu vyslovovani), to by normalniho cloveka taky polozilo na lopatky (odrovnalo hlasivky).”
Text → Oko → Mozek → Prsty
vs.
Text → Oko → Mozek → Huba → audio záznam. a následně, audio záznam → Ucho → Mozek → Prsty
Kterážto realizace je (nejenom) časově mnohem náročnější. Je to stejně praštěné řešení, jako nahrávání dění na terminálu ve formátu mp4.
 18.3.2025 15:00
Bystroushaak | skóre: 36
| blog: Bystroushaakův blog
| Praha
Na obrázku jsou viditelné následující knihy (některé názvy jsou částečně čitelné):API call stojí pár korun.Další knihy nejsou kvůli úhlu či rozlišení jasně čitelné. Pokud potřebuješ informace o nějaké konkrétní knize, dej mi vědět!
- Farmakologie
- Farmakoterapie vnitřních nemocí
- Barevný atlas farmakologie
- Mechanika zemin
- Úvod do informatiky
- Medicína
- Psychoterapeutické směry
- No vnímání umění
- Moderní fyziologie
- Společenský rozvoj
- Základy psychologie
- Klinická propedeutika
- Základy pediatrie
- Lékařská péče o dítě
- Anatomie člověka
- Chirurgie pro studenty medicíny
 22.3.2025 15:11
jose17 | skóre: 44
| blog: Joseho_blog
| Bratislava
pip bez virtualneho environmentu? curl pipovany do shellu? ale no fuj!
Tady doporučují: „Řešením může být Tesseract který si ale musíš natrénovat.” Víc ti bohužel neporadím, protože tak do hloubky jsem s ním nikdy nedělal.
Já vím. Však jsem to nenabízel jako hotové řešení. Na té odkazované stránce píšou kde je kámen úrazu. Máš jenomdvě možnosti. Buď to zkusit. Nebo vyhledat někoho kdo to za patřičný obnos přepíše do počítače.
Tiskni
Sdílej:


 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz

 16.3.2025 21:21
 17.3.2025 17:54