Byl vydán Sublime Text 4 Build 4213. Sublime Text (Wikipedie) je proprietární multiplatformní editor textových souborů a zdrojových kódů. Ke stažení a k vyzkoušení je zdarma. Pro další používání je nutná licence v ceně 99 dolarů. Spolu se Sublime Merge je cena 168 dolarů.
Firma Anthropic, tvůrce AI modelu Claude, začala v oblasti Sanfranciského zálivu v tichosti provozovat vlastní biotechnologickou laboratoř. Anthropic prý chce pomocí AI urychlit hledání léků na nemoci, jimž farmaceutický průmysl dle názoru firmy věnuje příliš málo pozornosti. Firma tvrdí, že laboratoř se zatím soustředí především na základní biologii, nikoli přímo na vývoj léčiv. Farmaceutický výzkum je pro generálního ředitele Daria Amodeie velice osobní téma, jeho otec zemřel na hepatitidu C několik málo let před objevením účinné léčby.
Vědci z Googlu dokončili mapu všech neuronových spojení v mozku (tzv. konektom) samečka mušky octomilky obecné (drosophila melanogaster), hlavním cílem je komparativní analýza s již zmapovaným mozkem samičky. S tímto veřejně dostupným modelem, čítajícím přibližně 160 000 neuronů, se začali bavit nadšenci. Mozek mouchy pohání experimentálního kryptoburzovního bota Stonkfly, případně si zahrál počítačové hry Beat Saber, Mario64 a samozřejmě DOOM (gameplay videa). Ani mozek samičky nezůstal stranou, vyzkoušel si Minecraft.
Alibaba Cloud je dalším sponzorem nadace Omacom Foundation stojící za linuxovou distribucí Omarchy. Přislíbená částka je 3 miliony dolarů, tj. 1 milion dolarů ročně po dobu tří let. Stejná částka jako u DigitalOcean.
Byla vydána nová verze 262 správce systému a služeb systemd (Wikipedie, GitHub).
Canonical oznámil vydání Zephyr 26.04 LTS. Jedná se o komerční distribuci operačního systému pro mikrokontroléry Zephyr (Wikipedie) s podporou až 15 let.
Gravity Linux je linuxová distribuce určená pro Apple Silicon s čipy M4 a novějšími. Vydána byla alfa verze pro M4 Mac mini. Gravity Linux je fork Asahi Linuxu.
Hister je osobní soukromý vyhledávač, který lze provozovat na vlastním stroji. Umí prohledávat lokální soubory, importovat historii a záložky z webových prohlížečů, procházet vybrané weby a pomocí rozšíření pro Firefox a Chrome indexovat obsah právě navštívených stránek. Nad vytvořeným indexem pak nabízí vyhledávání prostřednictvím webového rozhraní, příkazové řádky a díky podpoře MCP i nástrojům umělé inteligence. Tento
… více »Ministerstvo dopravy uznalo prozatímní schválení asistenčního systému Tesla FSD Supervised vydané nizozemským schvalovacím orgánem RDW. Připojilo se tak k Nizozemsku a dalším pěti evropským státům. Systém je díky tomuto rozhodnutí možné používat za podmínek prozatímního schválení také na území České republiky. Tesla FSD Supervised je asistenčním systémem úrovně 2 podle klasifikace SAE (částečná automatizace řízení). Řidič se
… více »Někteří zákazníci O2 mohou aktuálně zaznamenat zhoršenou dostupnost internetových služeb. Na odstranění potíží se pracuje [Facebook].
Aneb malé povídání o n-gramech a Rku. Honzíkovi slibuji, že to bude mít větší hodnotu a lepší formátovaní než minule!
O co nám dnes půjde? Na vstupu máme titulky (anglické) z kompletní první série seriálu Southpark a budeme zjišťovat, jestli se v textu neobjevují nějaké opakující se patterny. K analýze nám poslouží tradičně jazyk R a jeho knihovny textcat, tau a k zobrazení výsledků pak wordcloud.
Jako první si někde obstaráme textové soubory s titulky, které budeme analyzovat. Ty umístíme do jednoho adresáře, v našem případě nazvaném "southpark", a s tím již pracujeme v R. Dále načteme potřebné knihovny a vytvoříme korpus, který bude obsahovat náš adresář.
library(textcat)
library(tau)
library(wordcloud)

korpus <- Corpus(DirSource("southpark", encoding="UTF-8"), readerControl = list(language = "en"))
Dále si do proměnné ngramy uložíme výsledek funkce textcnt, které předáváme v parametru n řád n-gramu. Postupně jsem to provedl pro n=1, 2, 3 a 4.
ngramy <- textcnt(korpus, method = "string",n=3)
Abychom mohli výsledek zobrazit jako wordcloud, musíme jej převézt z formátu textcnt na dataframe. To řeší následující příkaz:
df <- data.frame(word = names(ngramy), freq=unclass(ngramy))
Zbytek již je opakování z minula:
pal2 <- brewer.pal(8,"Dark2")
png("wordcloud_ngram.png", width=1024,height=768)
wordcloud(df$word,df$freq, scale=c(10,.2),min.freq=3,
max.words=150, random.order=FALSE, rot.per=.15, colors=pal2)
dev.off()
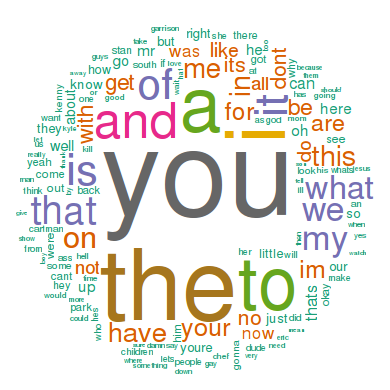
V prvním kroku nám vyjde úplně normální wordcloud, který je dosti nevypovídající - nebyla použita žádná stopwords, a tak převládají členy "a" a "the".
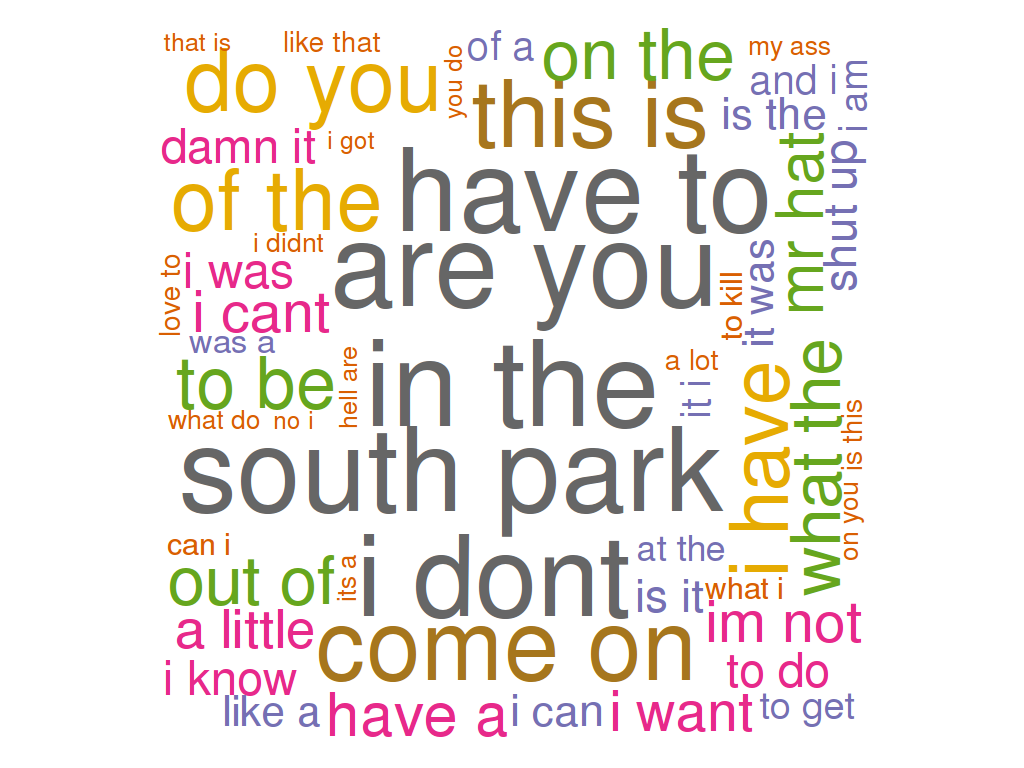
V dalším kroku pro n=2 je výsledek již zajímavější. Mezi nejčastějšími spojeními dvou slov se nám již objeví "south park", ale pořád to hyzdí nicneříkající "have to", "are you" a podobné.
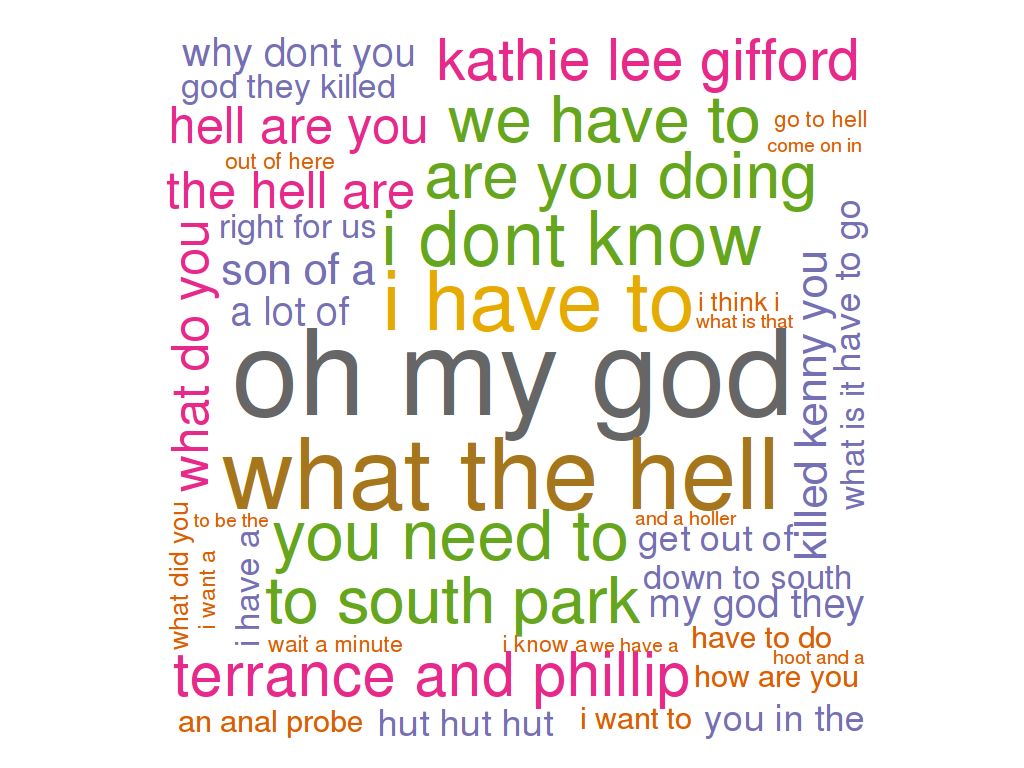
U n=3 začíná být výsledek již opravdu zajímavý. Mezi nejčastějšími tříslovnými výrazy se objevují věci jako "oh my god", což je klasická Cartmanovská hláška, popřípadě "Terrance and Phillip" podle které Southpark zcela jistě identifikujeme a "Kathie Lee Gifford", která prostě musí zemřít!
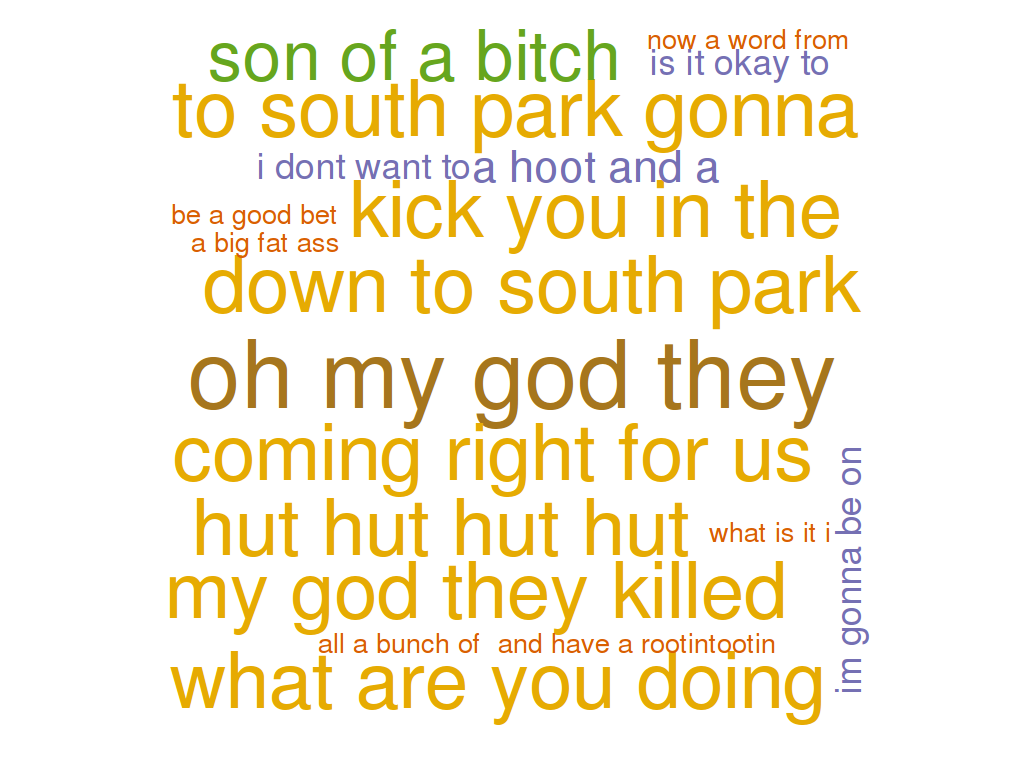
A máme tady zlatý hřeb večera - n=4! Zde dominuje především asi nejvíce WTF věta "hut hut hut hut", u které doteď nevím co znamená. Southpark se dá rozeznat podle "my god they killed" a "a big fat ass". Pro n-gram pro čtyři slova je problematická především malá délka vstupního textu, kvůli čemuž máme velmi málo výsledků a nejsou příliš reprezentativní.
Jako bonus jsem spočítal a vykreslil do grafu vzdálenost slov "killed", "kenny" a "bastards" v jednotlivých epizodách. Výsledek zde:
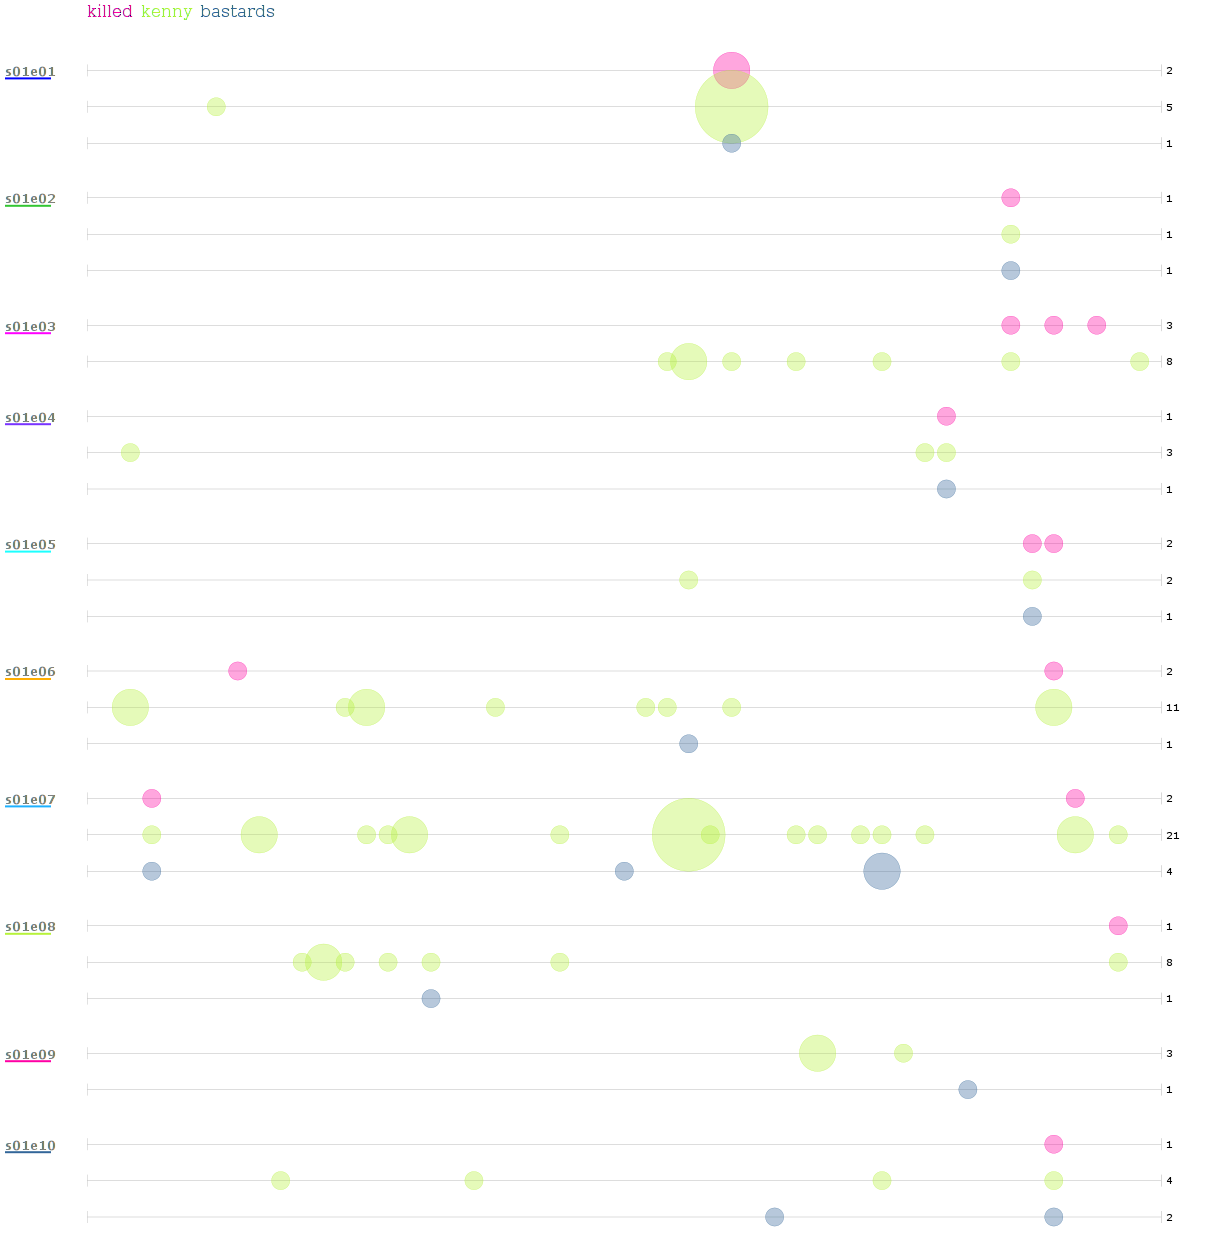
Měření dopadlo úspěšně a nebyl při něm nikdo zraněn. Na pár příkladech jsme si předvedli, jak analyzovat text z pohledu výskytů sousloví. Největší smysl dávají asi 3-gramy, u kterých jde relativně dobře poznat, jaký text byl analyzován. U kratších spojení narážíme na přílišnou obecnost, zde by bylo potřeba implementovat zakázaná slova. U delších je pak problém v krátkosti textu. Pokud byste si chtěli něco podobného zkusit a nechtěli si při tom složitě instalovat R a hledat, které RStudio je nejlepší, vyzkoušejte online Voyant-tools. O kostičku se hlaste v komentářích!
Tiskni
Sdílej:


 2.2.2014 23:01
Bedňa | skóre: 34
| blog: Žumpa
| Horňany
2.2.2014 23:58
Bedňa | skóre: 34
| blog: Žumpa
| Horňany
3.2.2014 00:10
Bedňa | skóre: 34
| blog: Žumpa
| Horňany
 2.2.2014 23:50
AsciiWolf | skóre: 41
| blog: Blog
 3.2.2014 10:03
pools | skóre: 19
| blog: Svědek Damdogův
| Opava/Praha
 3.2.2014 21:22
Agent
| blog: Life_in_Pieces
| HC city
 5.2.2014 09:44
grubber | skóre: 6
| blog: grubber
| Břeclav / Brno
Zde dominuje především asi nejvíce WTF věta "hut hut hut hut", u které doteď nevím co znamená.Že by More crap?
5.2.2014 17:04
pools | skóre: 19
| blog: Svědek Damdogův
| Opava/Praha
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz

 3.2.2014 11:02