Byla vydána OpenIndiana 2026.10. Unixový operační systém OpenIndiana (Wikipedie) vychází z OpenSolarisu (Wikipedie).
Americký výrobce polovodičů onsemi (ON Semiconductor) zrušil plány na rozšíření výroby v rožnovském závodě v Česku za dvě miliardy dolarů (podle aktuálního kurzu zhruba 43,5 mld. Kč). Důvodem je vývoj na trhu.
O víkendu probíhá na FIT VUT v Brně konference OpenAlt 2026 o otevřeném softwaru a datech, IT bezpečnosti, DIY a IoT. Na programu je spousta zajímavých přednášek. Pokud jste v Brně, stavte se. Vstup zdarma. Přednášky lze sledovat i online na VHSky a YouTube.
Qualcomm uzavřel víceletou dohodu se SpaceX. Bude dodávat rádiové technologie, baseband jednotky a software pro plánovanou pozemní 5G síť Starlink Mobile. Výstavba má zahrnovat desítky tisíc základnových stanic v USA. Zahájení nasazování se očekává v roce 2027. Qualcomm dohodu označuje za svůj dosud největší 5G kontrakt.
Google rozšířil Cloud Vulnerability Reward Program. Nově nabízí odměnu až 250 tisíc dolarů za vysoce závažné architektonické bezpečnostní chyby označované jako Root-in-Cloud.
V březnu byla oznámena spolupráce GrapheneOS s Motorolou. Nejnovější vlajka Motorola Signature 27 je první Motorola s oficiální podporou GrapheneOS. GrapheneOS (Wikpedie) je varianta Androidu zaměřující se na bezpečnost a soukromí.
Omarchy (Wikipedie) je linuxová distribuce s dlaždicovým správcem oken Hyprland. Založena je na Arch Linuxu. Vydána byla v nové verzi 4.5.0. Nově také pro Apple Silicon, konkrétně pro M1/M2/M3/Neo MacBooky.
Byla vydána nová stabilní verze 8.3 webového prohlížeče Vivaldi (Wikipedie). Postavena je na Chromiu 156 s bezpečnostními opravami z Chromia 157. Přehled novinek i s náhledy v příspěvku na blogu.
Odkazy

Pri vývoji webových aplikácií je bežnou požiadavkou aby bol obsah viacjazyčný. Tento blog sa zaoberá návrhom modelov pre uloženie viacjazyčných dát a výhodami / nevýhodami jednotlivých návrhov.
Jazyk SQL neposkytuje žiadnu vstavanú podporu pre viacjazyčný obsah. Návrh databázovej schémy pre viacjazyčný obsahu tak zostáva len na databázovom programátorovi.
Na internete je možné nájsť veľké množstvo rôznych databázových schém, ktoré riešia viacjazyčný obsah. Nedá sa všeobecne povedať ktorá schéma je najlepšia. Vždy to závisí od konkrétneho prípadu použitia. V nasledujúcom texte som sa pokúsil zhrnúť výhody a nevýhody jednotlivých prístupov.
V celom blogu budem aplikovať návrh na model článkov. Polia nazov a obsah budú prekladané. Zvyšné polia budú rovnaké pre každý jazyk.
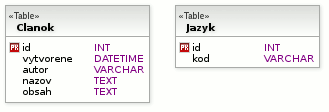
Tabuľka jazykov bude vyzerať nasledovne:
| id | kod |
|---|---|
| 1 | sk |
| 2 | cz |
V selectoch budem vyberať slovenskú lokalizáciu. Pre jednoduchosť nebudem používať join s tabuľkou jazykov. Namiesto toho budem priamo ako ID jazyka používať 1.
Pri tomto prístupe nedochádza k zmene schémy a preklady pre všetky jazyky sa ukladajú do tej istej bunky v špeciálnom formáte. Ako príklad si požičiam formát používaný pluginom qTranslate z Wordpressu. Nasledujúci kód reprezentuje český a slovenský preklad slova „Článok“.
<!--:sk-->Článok<!--:--><!--:cz-->Článek<!--:cz-->
Výber objektov je veľmi jednoduchý. Dáta je však potrebné následne spracovať v aplikácii.
SELECT vytvorene,
       autor,
       nazov,
       obsah
FROM clanok;
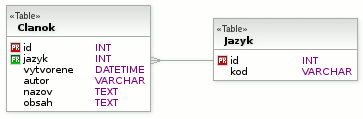
Pri tomto prístupe sa do modelu pridá jediný stĺpec určujúci jazyk. Medzi jazykovými mutáciami nie je žiaden vzťah, takže v jednej jazykovej mutácii môžu byť úplne iné položky než v inej jazykovej mutácii, čo môže byť v niektorých prípadoch výhodné. Pri pridaní, alebo odstránení jazyka nie je potrebná žiadna modifikácia schémy.
Pre výber slovenských objektov stačí pridať podmienku where.
SELECT vytvorene,
       autor,
       nazov,
       obsah
FROM clanok
WHERE jazyk = 1;
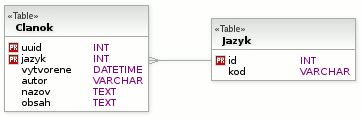
V tomto modeli bude primárnym (alebo minimálne unikátnym) kľúčom dvojica uuid a jazyk. Objekty (články) sú identifikované stĺpcom uuid. Ten bude rovnaký pre všetky preklady článku.
Výber objektov je identický ako v prípade predchádzajúceho modelu.
uuid pre objekty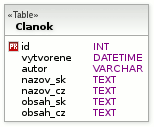
Do modelu pridá každý stĺpec toľkokrát, koľko jazykov bude v aplikácii podporovaných. Nepreložené stĺpce zostávajú bez zmeny.
Pre výber položiek v konkrétnom jazyku je potrebné modifikovať samotný dotaz. Jazykové suffixy musia byť preto chránené voči SQL injection.
SELECT vytvorene,
       autor,
       nazov_sk AS nazov,
       obsah_sk AS obsah
FROM clanok;
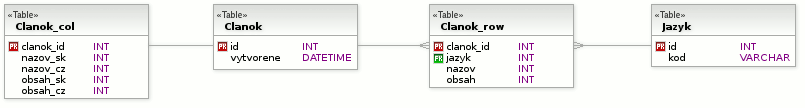
Oproti predchádzajúcim spôsobom sa tu využívajú 2 tabuľky - časť pôvodnej tabuľky neobsahujúca preklady a tabuľka prekladov. Tá môže byť implementovaná buď prekladmi v riadkoch, alebo v stĺpcoch.
Pri výbere sa používa v oboch prípadoch join, čo môže mať vplyv na výkon. Pri použití tabuľky s prekladmi v stĺpcoch sa pri výbere v konkrétnom jazyku zase modifikuje dotaz a je potrebné zabezpečiť ho voči SQL injection.
-- clanok_row
SELECT vytvorene,
       autor,
       nazov,
       obsah
FROM clanok
INNER JOIN clanok_row
ON clanok.id = clanok_row.clanok_id AND jazyk = 1;

-- clanok_col
SELECT vytvorene,
       autor,
       nazov_sk AS nazov,
       obsah_sk AS obsah
INNER JOIN clanok_col
ON clanok.id = clanok_col.clanok_id;
Na túto otázku neexistuje jednoznačná odpoveď. Ak máme pevne danú schému, ktorú nemôžeme prispôsobiť bude jediným možným spôsobom uloženie všetkých prekladov oddelených rozumne zvoleným oddeľovačom do pôvodných buniek.
V prípade, že máme rôzny obsah v každom jazyku (napr. v každom jazyku budú iné články) bude najvhodnejším riešením model bez vzťahov medzi jazykmi. Ak však budeme chcieť tie isté objekty v rôznych jazykových mutáciách budeme musieť zvoliť inú schému.
Preklady v riadkoch poskytujú vysokú flexibilitu v možnosti zmeny podporovaných jazykov. V prípade článkov sa pri prekladoch bude opakovať autor a dátum. Schému je možné normalizovať rozdelením tabuľky na samostatnú tabuľku prekladov a zvyšný obsah (posledný príklad).
Preklady v stĺpcoch zachovávajú počet riadkov rovnaký ako počet objektov. Schéma je vhodná len v prípade, že sa v budúcnosti nebude manipulovať s podporovanými jazykmi. Pri väčšom počte jazykov a stĺpcov s prekladmi môže byť táto schéma veľmi neprehľadná. Presun prekladov do samostatnej tabuľky slúži len na sprehľadnenie pôvodnej tabuľky.
Tiskni
Sdílej:


 29.9.2012 07:49
mirec | skóre: 33
| blog: mirecove_dristy
| Poprad
Dovolím si o výkone JOINu tak trochu nesúhlasiť. Robievam s dosť veľkými databázami a nie len MySQL, ale aj s podstatne výkonnejšou PostgreSQL. Joiny (LEFT aj INNER) môžu mať podstatný vplyv na výkon. Nedávno som riešil problém s pomalým selectom (~2s). Po odstránení joinu klesol čas na ~0.01s. Samozrejme indexy boli nastavené správne a join ich používal.
Problémom v mojom prípade bola veľkosť tabuľky (> 100 000 riadkov) a výber 10 prvkov s offsetom 100 000. Pri výbere bez joinu to pre databázu znamená jednoduchý odskok na 100 000 pložku a vrátenie 10 nasledujúcich položiek. Operácia join však môže vrátiť aj viac, alebo menej riadkov než je v prvej tabuľke. Preto musí databáza pri offsete 100 000 skutočne vykonať join na 100 000 riadkoch. Ak samozrejme ide len o výber s malým offsetom bude mať join zanedbateľný vplyv.
So zvyškom príspevku súhlasím, sám dokonca nepoužívam id jazyka.
29.9.2012 12:32
mirec | skóre: 33
| blog: mirecove_dristy
| Poprad
Pokud jde join přes primární nebo unikátní klíč, tak by s tím neměl být problém.
Práve, že tu problém je pretože ten join sa minimálne v postgresql materializuje. Obísť sa to dá limitom v subselecte. Nedávno som to riešil v jednej django aplikácii. Musel som optimalizáciou zájsť až po RAW query.
 30.9.2012 11:40
bertone
| blog: Bertone
| Bratislava
30.9.2012 11:47
bertone
| blog: Bertone
| Bratislava
30.9.2012 12:36
mirec | skóre: 33
| blog: mirecove_dristy
| Poprad
30.9.2012 19:45
mirec | skóre: 33
| blog: mirecove_dristy
| Poprad
30.9.2012 21:07
mirec | skóre: 33
| blog: mirecove_dristy
| Poprad
 . Inak dobrý nápad blog o graphvize, ale predtým možno niečo napíšem o AVR, a hackovaní TV LG a tak ... jednoducho čo mám čerstvo v pamäti
 3.10.2012 19:59
mirec | skóre: 33
| blog: mirecove_dristy
| Poprad
3.10.2012 22:30
mirec | skóre: 33
| blog: mirecove_dristy
| Poprad
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz

 29.9.2012 00:48
 29.9.2012 11:04
 Ale čechom sme mohli dať 0 .. alebo -1 :-p