Projekt openSUSE dnes, 3. listopadu 2026, oficiálně vydal openSUSE Leap 16.1, novou verzi své stabilní linuxové distribuce. Novinkou je také Immutable Mode, který nahrazuje dosavadní samostatnou distribuci openSUSE Leap Micro. Podrobnosti o novém vydání najdete v oficiálním oznámení nebo v českém překladu oznámení. Instalační obrazy jsou již dostupné na get.opensuse.org. Vydání společně oslavíme v pátek ve virtuálním baru a na … více »
Bylo oznámeno vydání Fedora Linuxu 45. Ve finální verzi vychází šest oficiálních edic: Fedora Workstation a Fedora KDE Plasma Desktop pro desktopové, Fedora Server pro serverové, Fedora Cloud pro cloudové nasazení, Fedora CoreOS pro ty, kteří preferují neměnné systémy a Fedora IoT pro internet věcí. Vedle nich jsou k dispozici také další atomické desktopy, spiny a laby. Podrobný přehled novinek v samostatných článcích na stránkách
… více »Vědci z MIT CSAIL představili koncept 'weight-space programming' a názorně předvedli, že pokročilé jazykové modely SI dokážou přímo číst a upravovat váhy neuronových sítí. Studie ukazuje, že modely nejen dokážou identifikovat účel sítí z pouhého nahlédnutí do jejich číselných vah, ale mohou i cíleně opravovat chyby a nedostatky, například GPT-6 Astra se změnou pouhých 0,016% vah open-weight modelu Qwen3.5-0.8B podařilo odstranit
… více »Organizátoři komunitního setkání nejen českých a slovenských správců sítí CSNOG 2027, které se uskuteční 20. a 21. ledna na půdě zlínské univerzity Tomáše Bati, oznámili prodloužení termínu pro zasílání abstraktů do programu akce. Zájemci se mohou hlásit prostřednictvím webu setkání do úterý 10. listopadu. Programová komise uvítá příspěvky věnované nejen správě sítí, ale také legislativě a regulaci nebo síťařským aktivitám studentů a pedagogů.
Bylo spuštěno předobjednávání zařízení Flipper One s Linuxem. Za 20 dolarů si lze koupit kupón a zajistit si tím speciální cenu 379 dolarů po spuštění kampaně na Kickstarteru.
Tor Browser, tj. fork webového prohlížeče Mozilla Firefox s integrovaným klientem sítě Tor přednastavený tak, aby přes tuto síť bezpečně komunikoval, byl vydán ve verzi 16.0. Postaven je na Firefoxu ESR 153. Vydána byla také nová verze 7.16 živé linuxové distribuce Tails (The Amnesic Incognito Live System), jež klade důraz na ochranu soukromí uživatelů a anonymitu. S Tor Browserem 16.0.
FreeTube, desktopový klient pro YouTube využívající lokální API, byl vydán ve verzi 0.26.0. Toto velké opravné vydání mj. vrací částečnou podporu živých přenosů nebo přepracovává zobrazování titulků a obecně nastavení videa v přehrávači – FreeTube umožňuje např. přehrávat video s větším zrychlením.
Další vlna kyberútoků zasáhla chladicí zařízení supermarketů v sedmi evropských zemích, Belgii, Lucembursku, Švédsku, Nizozemsku, Irsku, Estonsku a Finsku. Mrazáky se v některých prodejnách opět 'proměnily v trouby' a zahřály až na 50°C, což pochopitelně vedlo ke znehodnocení uskladněných potravin. Útoky navazují na podobný incident ve Francii z první poloviny října letošního roku, pachatel stále není znám.

V diskuzích k mému dvoudílnému článku o automatizovaném retušování digitalizovaných textů ([1], [2]) se Filip Jirsák opakovaně pozastavoval nad tím, proč rovnou nepoužít OCR, které retušování udělá také, a může ho udělat lépe. Již v diskuzi jsem zmínil, že mé zkušenosti s OCR nejsou velké, a nyní dodávám, že to málo, které mám, je poněkud rozpačité. Přesto mi to nakonec nedalo, abych jednu dvoustranu ze zpracovávaného dokumentu nezkusil procesem rozpoznávání textu prohnat.
Jestli jsem Filipovým poznámkám správně porozuměl, předmětem sporu jsou odstraňování šumu a šedého pozadí; ostatní úpravy jako odstranění černých okrajů, ořez a korekce sklonu se zdají být pochopitelné. Co se šumu týče, asi mělo být v článku více zdůrazněno, že filtr unpaperu je ve výchozím nastavení opravdu citlivě nastaven, tj. že odstraňuje prakticky pouze jednopixelové body, pokud zároveň v nejbližším okolí je jen velmi málo jiných bodů, takže i při relativně nízkém rozlišení skenovaných dokumentů a malém písmu skutečně nehrozí, že by filtr postihl interpunkci či podtržení. Samozřejmě je žádoucí si výsledek filtru na vzorku zkontrolovat a v případě potřeby upravit jeho intenzitu či jej úplně vypnout.
Odstraňování šedého pozadí možná byl v článku věnován mnohem větší prostor, než si ve skutečnosti zaslouží – pokládám za náhodu, že jsem se potkal se zvýšeným počtem knih, které rámečky se šedým pozadím používaly, jinde se s nimi asi v takové míře nesetkáte. Každopádně zde nelze mluvit o nějakém obecném retušování, naopak šlo o nastudování vzorku tohoto šumu a sepsání algoritmu přesně cíleného na jeho odstranění. Jak by v tom nějaké OCR mohlo být lepší?
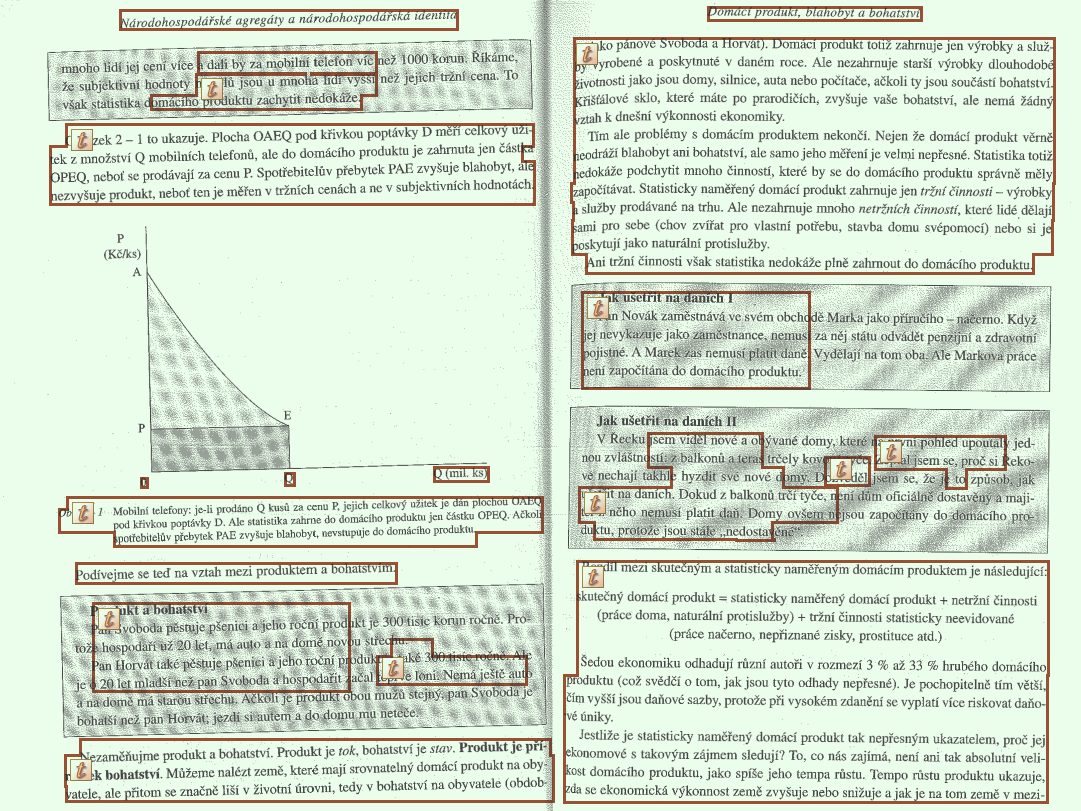
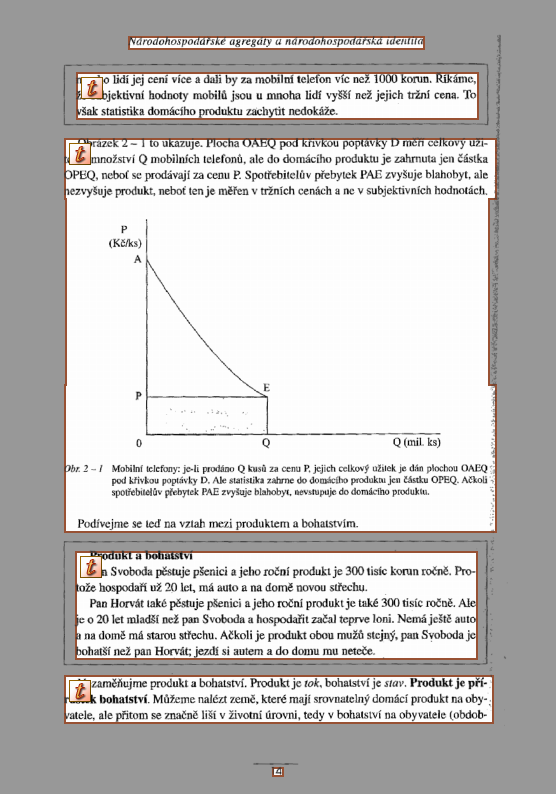
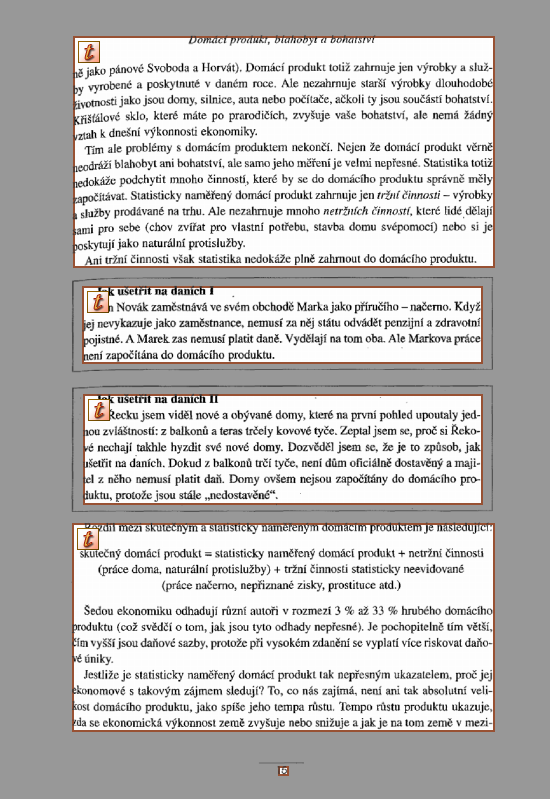
A nyní k provedenému testu: nechal jsem zpracovat originální sken a retušovaný sken jedné dvoustrany obsahující mimo jiné i texty v šedých rámečcích. Jak dokazují přiložené snímky obrazovky, na textu v šedých rámečcích v originálním obrázku si OCR vylámalo zuby, za text označilo jenom části rámečků a písmena v nich nepoznalo správně. V retušovaných obrázcích mělo OCR u textů v rámečcích stejnou úspěšnost jako u jiného textu mimo rámeček. Co se běžného šumu týče, zde dávám Filipovi za pravdu, s tím OCR problém nemá.
Použité OCR bylo OmniPage 4.0 SE, což asi nebude žádný zázrak pod Sluncem, přesto to potvrzuje mou hypotézu, že retušování může OCR pomoci. I když třeba jiné OCR s vhodným profilem může uspět lépe (dokud neuvidím, neuvěřím), asi budu raději dál retušovat než-li ztrácet čas hledáním vhodného profilu.
Tiskni
Sdílej:


netpbm, na zakódování pak DJVU. S programem unpaper jsem před několika lety příliš spokojen nebyl. Škoda, že teď nemám zrovna nic, na čem bych jej opět vyzkoušel, možná se už zlepšil. Samotné rozpoznávání pak zavrhuju proto, že jej nemám čím provádět, navíc by posloužilo jen jako text pro prohledávání DJVU. A to zvládne i on-line služba any2djvu.
 24.7.2009 12:47
Jiří Poláček | skóre: 47
| blog: naopak
| Sivice
Originály jsou černobílé v rozlišení 200 dpiAlespoň to, ať můžeme porovnat alespoň něco.
Retušovať, potom rozpoznávať a rozpoznané uložiť ako vrstvu pod text - DJVU alebo PDF. My tak robíme, sprístupnili sme zopár oscannovaných kníh a časopisov, tak som sa s tým kedysi dosť hral. Článok je na veľmi dobrej úrovni, škoda že nebol píaný pred pár rokmi, takto som si to všetko musel poobjavovať sám 
Rozpoznávanie a použiitie textu bez grafickej verzie je nanič - chybovosť je ta jeden-dva znaky na riadok (dosť, ak ide o publikáciu, kde na znakoch záleží), ale hlavne hrozí veľké riziko zblbnutia rovníc, tabuliek, schém apod. Pre beletriu to nie je až také podstatné, pre vedeckú literatúru veľmi.
24.7.2009 12:52
Jiří Poláček | skóre: 47
| blog: naopak
| Sivice
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz