Stát Kalifornie zažaloval výrobce 3D tiskových filamentů Polymaker. Vrchní soud San Diego County tvrdí, že firma propagací svých výrobků mezi příznivci 3D tištěných zbraní podporovala výrobu takzvaných 'ghost guns' (DIY zbraní) a že její PLA filament pro 3D tiskárny lze za těchto okolností považovat za součást určenou k výrobě střelné zbraně. Žaloba požaduje mimo jiné finanční sankce a soudní zákaz činnosti, Polymaker se hájí tím, že filament je běžný a sám o sobě legální produkt. Celý text žaloby (PDF na Google Drive).
V červnu byla představena aplikace Myna pro převod řeči na text v prostředí desktopu Ubuntu. Včera byla Myna zpřístupněna širší komunitě Ubuntu formou technologické ukázky dostupné v Ubuntu 24.04 LTS, Ubuntu 26.04 LTS a Ubuntu 26.10 s GNOME na Waylandu.
Ubuntu 27.04 bude Tenacious T-Rex.
Byla vydána nová verze 2026.4.0 "Never-slop" svobodného softwaru ScummVM (Wikipedie) umožňujícího bezproblémový běh mnoha klasických adventur na zařízeních, pro které nebyly nikdy určeny. Přehled novinek v poznámkách k vydání a na GitHubu. ScummVM oslavil 25 let. Verze 0.0.1 vyšla 8. října 2001.
Kanadský vývojář Anthony Sistilli vytvořil ironický DIY projekt parodující kamerové systémy Flock, s cílem názorně demonstrovat rizika masového sledování jaké provozují tyto komerční ALPR systémy. Z levné IP kamery a vlastního ML softwaru (napsaného s pomocí SI circa za 20 minut, kód se mi bohužel nepodařilo dohledat) běžícího v laptopu sestavil jednoduchý systém, který detekuje výhradně policejní vozidla, zaznamenává jejich SPZ a
… více »Část údajů uživatelů internetového supermarketu Rohlík byla odcizena. Kyberútočníci napadli nástroj zákaznické podpory Rohlíku, odcizili tak jména, e-mailové adresy, v některých případech také telefonní čísla nebo přepisy komunikace mezi klienty a zákaznickou podporou. Rohlík incident nahlásil příslušným orgánům a přijal příslušné opatření, aby zamezil podobným případům v budoucnosti, uvedla firma.
Aplikace eDoklady fungovala v obou volebních dnech stabilně a prakticky bez front. Digitální a informační agentura (DIA) odhaduje, že se digitálním dokladem prokázalo více než 100.000 voličů. Aplikaci si před volbami či během nich aktualizovalo 247.517 uživatelů. Nových registrací bylo 19.431 a do aplikace se přihlásilo 357.879 lidí. Největší nápor přišel bezprostředně po otevření volebních místností mezi 14. a 16. hodinou, kdy si
… více »Začal semestr, začal i podzim a kromě hub rostou jako po dešti i veřejné dílny v Praze. Nedávno strahováci referovali o hackerspacu Bordel, nyní se otevřela dílna Dejvice Lab jen kousek od ČVUT. Na blížící Virtuální Bastlírně tak uslyšíte nejen report z návštěvy dílny HWLab, ale i řadu novinek, událostí a úsměvných momentů, které se za poslední měsíc ve světě techniky, ale i vědy udály. Připojte se tedy již v úterý 13.10. od 20:00 a zapojte se do
… více »Byl vydán LineageOS 24 (Mastodon). LineageOS (Wikipedie) je svobodný operační systém pro chytré telefony, tablety a set-top boxy založený na Androidu. Jedná se o nástupce CyanogenModu. LineageOS 24 je založený na Androidu 17.
Společnost Valve publikovala na svém GitLabu nákresy a schémata zapojení headsetu Steam Frame. Pro nekomerční účely.

 . Nejprve začnu tím, jak to bylo uděláno předtím (ve zkratce: hloupě) a pak popíšu, jak je to uděláno teď s využitím jedné pěkné datové struktury.
Oproti tomu nové řešení je strašně super. Celé je postavené na upravené datové struktuře Trie přidávající hashování. O tom, jak funguje trie psát nebudu, kdo to neví, ať to přečte. Standardní trii jsem se ale rozhodl trošičku optimalizovat, a to použitím hash tabulky pro první rozdílné písmeno za prefixem. V praxi rozdíl nebude, protože se zpracovává málo dat, ale chtěl jsem si to vyzkoušet . Hlavně pokud by to mělo k něčemu být při zpracování většího množství dat, tak by se hash tabulka musela používat pro větší část prefixu (třeba tři písmena), protože projít abecedu je mžik. Každopádně už to tak je a funguje to.
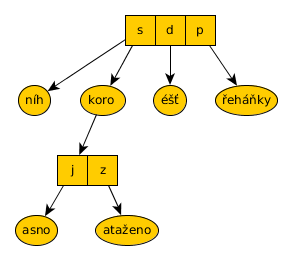
Pro lepší ilustraci obrázek, co vznikne vložením „sníh“, „skoro jasno“, „skoro zataženo“, „déšť“ a „přeháňky“ do této datové struktury. První je na řadě hash tabulka pro počáteční písmena prefixů „s“, „d“, „p“. Protože déšť a přeháňky nemají společný prefix, jsou uloženy (kromě prvního písmena) do samostatných uzlů do kterých ukazuje záznam pro „d“, resp. „p“ z hash tabulky. Zajímavé jsou ale „skoro jasno“ a „skoro zataženo“. Protože se liší prvním písmenem za „skoro “, tak se vytvoří nová hash tabulka, která ukazuje na další část slova.
Co se týče použití v praxi, tak došlo k následujícím změnám – veškerý starý kód parseru jsem vyhodil, a:
Díky těmto změnám je teď snadné podporovat víceslovná spojení a navíc došlo k výraznému zrychlení. IIRC parser zabral ca dvě třetiny času zpracování předpovědi, teď to je tuším někde kolem 2%.

Tiskni
Sdílej:


 26.6.2014 17:45
Rezza | skóre: 25
| blog: rezza
| Brno
26.6.2014 19:57
Rezza | skóre: 25
| blog: rezza
| Brno
 26.6.2014 21:57
stativ | skóre: 54
| blog: SlaNé roury
26.6.2014 22:34
Rezza | skóre: 25
| blog: rezza
| Brno
28.6.2014 11:25
Rezza | skóre: 25
| blog: rezza
| Brno
28.6.2014 13:40
stativ | skóre: 54
| blog: SlaNé roury
28.6.2014 16:55
Rezza | skóre: 25
| blog: rezza
| Brno
28.6.2014 20:32
stativ | skóre: 54
| blog: SlaNé roury
26.6.2014 21:19
stativ | skóre: 54
| blog: SlaNé roury
26.6.2014 21:36
stativ | skóre: 54
| blog: SlaNé roury
30.6.2014 21:20
stativ | skóre: 54
| blog: SlaNé roury
26.6.2014 20:58
stativ | skóre: 54
| blog: SlaNé roury
V tomhle případě byl význam si vyzkoušet, jestli to jde.
Teď k mojí teorii, která tedy má smysl až když se udělá hash na delší část textu. Předpokládám, že hashováním na několika písmenech se hledání rychle posune do nižší úrovně bez nutnosti přímo porovnávat různé prefixy. Důsledkem by vlastně bylo i snížení hloubky stromu. Př.: když by se vkládalo „něco“, „někdo“ a „foo“ a hash se dělal ze tří písmen, tak by si člověk odpustil porovnávání s „ně“ a s „foo“ ale v tomhle případě by se rovnou skočilo na výsledek. Podle mého názoru (nemám to nijak matematicky podložené*) by to tedy mělo výhodu v podstatě O(1) vyhledávání jako v hash tabulce, ale s tím, že by bylo menší množství kolizí při potřebě několika krátkých tabulek.
Tady asi čtenáře napadne, proč jsem vlastně nepoužil rovnou hash tabulku. Důvod je takový, že by musela být poměrně rozsáhlá aby zachytila všechny možné tvary slov. Tak, jak to mám implementováno teď, se do trie často vkládá jen část slova (třeba „sněh“) přičemž se vrací výsledek už když ten začátek pasuje (tedy pokud nepasuje nějaký delší prefix), tj. postihne to slova jako „sněhem“, „sněhové“ atd. což už by se s hash tabulkou dělalo asi docela špatně.
PS: nevykat 
* píšu si do TODO, protože by mě to samotného zajímalo
26.6.2014 22:57
stativ | skóre: 54
| blog: SlaNé roury
30.6.2014 12:18
stativ | skóre: 54
| blog: SlaNé roury
27.6.2014 22:50
stativ | skóre: 54
| blog: SlaNé roury
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz

 27.6.2014 11:56