Apple představil nový iPad mini, iMac s čipem M6, 14palcový MacBook Pro s čipem M6 a MacBook Pro s PROLED XDR displejem – první Mac s dotykovým ovládáním.
Nedávno představený projekt mapSTL.com řeší budoucnost. 𝕏: "Netušil jsem, kolik patentů na generování map existuje. Existují patenty na generování fantasy map 🫣. Cokoliv je na 3D tiskárnu a tvoří to produkt, bude to mít patenty. Tak bacha na to!" … více »
Multiplatformní emulátor terminálu Ghostty byl vydán ve verzi 1.4 (𝕏). Přehled novinek a vylepšení v poznámkách k vydání.
Byla objevena zranitelnost Tailworm v Tailscale a Headscale umožňující lokální eskalaci práv přihlášeného uživatele. Následně byla v Tailscale v opravené verzi 1.104.4+ změněna architektura aplikace. Viz příspěvek na blogu Tailscale.
Byl vydán Mozilla Firefox 159.0. Přehled novinek v poznámkách k vydání a poznámkách k vydání pro vývojáře. Řešeny jsou rovněž bezpečnostní chyby. Nový Firefox 159 bude brzy k dispozici také na Flathubu a Snapcraftu.
Nasazení softwaru, který nyní používá ve svých autech pro čínský trh, zvažuje automobilový koncern Volkswagen také v Evropě, kde by se mohl používat v budoucích vozech značek Volkswagen, Škoda a Cupra. Základem pro budoucí evropské modely by se mohla stát takzvaná China Electronic Architecture, elektronická architektura vyvinutá pro čínské modely ve spolupráci s tamní automobilkou Xpeng.
Vedoucím brněnské pobočky Red Hatu se stal Radek Vokál [LinkedIn].
Open source download manager Fatrat povstal z popela. Autor k dvacetiletému výročí projektu přidal do vínku podporu nejnovější knihovny libtorrent, rozhraní portoval na QT6, došlo k nahrazení podpory java rozšíření pythonem. Webové rozhraní bylo přepsáno s podporou mobilních zařízení. Aplikaci je taktéž možno zkompilovat bez podpory GUI. Více informací v releases.
Zranitelnost Broccoli2Shell (CVE-2026-111497) v kompresní knihovně Brotli se netýká pouze Node.js. Ohroženy jsou také aplikace využívající HTTP. Knihovnu používají webové prohlížeče, servery i řada dalších aplikací a technologií, například také Python nebo Bun. Identifikace všech zranitelných komponent může být obtížná, protože knihovna bývá součástí dalších softwarových balíčků nebo je přímo začleněna do spustitelných souborů aplikací.
Quad9, švýcarský celosvětově působící neziskový poskytovatel DNS, od 24. listopadu 2026 ukončí své služby ve Francii kvůli soudnímu sporu s katarskou televizní stanicí beIN. Ta požadovala blokování domén, které podle ní nelegálně zpřístupňují sportovní přenosy. Francouzský soud Katarům vyhověl a nařídil (🇫🇷, PDF) Quad9 blokaci zavést, pod hrozbou pokuty 1000 eur denně. Provozovatel příkaz odmítá s tím, že blokace
… více »
Tento zápisek volně navazuje na víc jak dva roky starý (ten čas ale letí...) článek Škálování quadcore při kompilaci jádra. Nevím kdy přesně v jádře přibyla volba pro hotplugování procesorů, každopádně nyní tam je a to nám umožňuje snadno emulovat počítač s méně jádry a docílit tím přesnějšího srovnání. Z hlediska CPU se změnilo za ty dva roky poměrně málo- stále zde máme čtyřjádrové procesory, frekvence se nehla ani o píď a zlepšení v architektuře nejsou ani na straně intelu (Nahalem) ani AMD (novější Phenomy) ničím, kvůli čemu by musel člověk sbírat čelist z podlahy. Snad jen servery s 2x čtyřjádrovými procesory jsou nyní častějším jevem, na desktopu to je ale relativně vzácnost.
2x X5482 (3.2 GHz), tyto procesory jsou více známy pod názvem Core 2 Extreme QX9775, protože pod tímto značením se prodávaly v Intel SkullTrail sestavách, 16 GiB DDR2 800 MHz FB DIMM
Jádro 2.6.31.5, vanilkové. gcc 4.3.4
Metodika se od minula nijak nezměnila akorát jsem neměřil kompilaci jádra se všemi volbami, neboť časy byly příliš dlouhé a já potřeboval provést spoustu měření. Použil jsem tedy .config jádra, které běžně používám. Pro simulaci počítače s méně jádry jsem použil "hotplug"
echo 0 > /sys/devices/system/cpu/cpuN/online //místo N se dosadí číslo jádra
kernel z něho odmigruje všechny procesy, zamorduje příslušné kernel thready a snad i přepne do nějakého úsporného režimu. Pro systém dané jádro přestane existovat, není ani v /proc/cpuinfo. Starší metodou je předání jádru parametru maxcpus při bootu a ještě starší omezení počtu procesorů v .config. Ne-SMP jádra, tedy s efektivnějšími implementacemi některých zámků, se už dneska v žádné distribuci nevyskytují ale ta volba v konfiguraci jádra stále je. Záměrně jsem tedy vynechal měření "jednojádra".
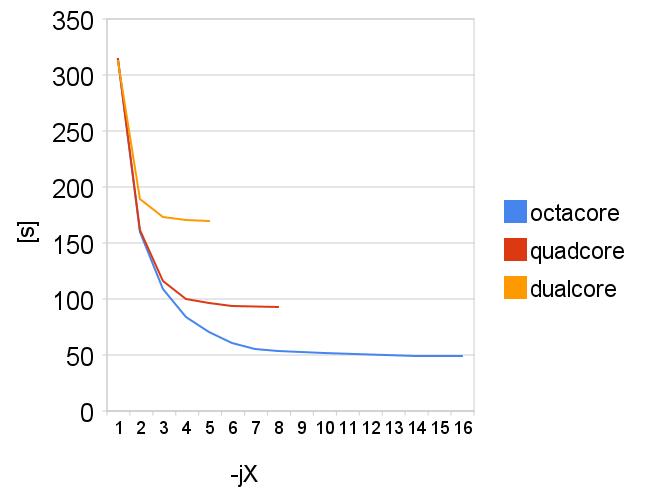
graf říká vše  Opticky se zdá, že osmijádro oproti čtyřjádru nedává výrazně lepší výsledky ale je to jen optický klam, osmijádo zvládne kompilaci 1.87x rychleji. Celkově vzato kompilace jádra škáluje velmi pěkně. Docela by mě zajímalo, jak by vypadala situace na i7 procesoru s aktivovaným hyperthreadingem.
Zajimavé poznatky přináší ješte hodnota user+sys, jinými sklovy kolik času procesory skutečně "odedřou". ta roste z 317 vteřin při -j1 lineárně k 350 při -j16. Jinými slovy o celých 33 vteřin práce procesoru příjdeme kvůli tomu, že se procesy točí ve spinlocku, počítají pomaleji kvuli tahanici o paměťovou sběrnici a L2 cache.
Pokud od rána do večera neděláte nic jiného, než že kompilujete jádo, tak běžte pro osmijádrový počítač. Pozor, tento test říká právě to a nic jiného. Vyvozování jakýchkoliv dalších závěrů jen na vlastní nebezpečí.
Tiskni
Sdílej:


 28.10.2009 16:01
vlastikroot | skóre: 24
| blog: vlastikovo
| Milevsko
 Ale pěkné, je vidět, že pres make se dají věci pěkně paralelizovat.
 28.10.2009 16:28
Nicky726 | skóre: 56
| blog: Nicky726
 28.10.2009 16:30
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
28.10.2009 17:09
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
28.10.2009 18:49
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
S(N) = 1/((1 - P) + (P / N)), kde P je cast algoritmu, ktera musi bezet sekvencne a N je pocet procesoru.
problem je, ze P nemusi byt konstanta. hodnota P je dana vstupnimi daty. coz je vicemene intuitivni, ma cenu paralelizovat velke ukoly nez male. a taky a to je hlavni, jsou pripady kdy P je funkci N... coz meni vyzneni celeho ,,zakona'', i.e., jde dosahnout linearniho i super-linearniho zrychleni! to znamena, ze v nekterych pripadech jde treba na dvoujadrovem procesoru dosahnou 10x zrychleni.
na druhou stranu, v pripade parallelniho programovani je potreba prehodnotit cely pristup k navrhu algoritmu a programu... protoze zkusenosti ze sekvencnich algoritmu jsou v pripade parallelnich algoritmu vicemene k nicemu.
Ale tady asi ani to ne páč 10x zrychlení na dvoujádru to ned8 ani backpruning, to je něco naprosto z jine galaxie řekl bych
vysoké školství produkuje praxií nepolíbené teoretiky-idealisty:-]]
to je něco naprosto z jine galaxie řekl bychto je jasne... svuj notas jsem koupil od dvou ferengu pri ceste po gama-kvadrantu! puvodne jsem ho ani nechtel, ale nakonec jsem se nechal ukacat. :-]
Ale tady asi ani to ne páč 10x zrychlení na dvoujádru to ned8 ani backpruning,takze taky teoretik? v praxi lze dosahnout superlinearniho zrychleni i s ,,beznyma parallelnima'' programama. staci si uvedomit, ze realny program nepouziva jenom CPU... a nadesignovat pak experiment, kde vyjde desetinasobne zrychleni na dvoujadru je uz jenom otazka cviku a trochy praxe. ;-]
To není k smíchu s tím školstvím, já jsem také jeho produktem, vím o čem mluvím
Tak mi nějaký takový experiment vycházejiící z praxe na reálném hardware a ne z akademického myšlenkového pokusu ukaž. Už jsem viděl i pokus o naprosto vyumělkované vytvoření algoritmu, který sázel na to, že se jeho working set vejde do L2 procesorů při rozdělení na víc části ale jako celek ne. Teoreticky vysněný případ. V praxi byl zisk jen nějakých 60 % páč se nepočítalo s n-asociativitou cache v reálných procesorech takže docházelo k přecpání některých řádků a na tom to celé zvadlo.
To není k smíchu s tím školstvím, já jsem také jeho produktem, vím o čem mluvímja jsem se smal necemu uplne jinemu... :-]]
Tak mi nějaký takový experiment vycházejiící z praxe na reálném hardwarevezmi si nejaky program a do jeho vlaken si pridej parkrat volani sleep(). uvidis, jaky to bude mit vliv na skalovani. ted si vem ten program a misto volani sleep si tam domysli, cekani na diskove I/O, cekani na sit, atd. bohuzel, z jistych duvodu nemuzu byt konkretnejsi...
Tak tim jsi to zabil naprosto.to si jen myslis, nebo jsi to i zkousel? na I/O se musi cekat za vsech okolnosti v sekvencni i nesekvencni variante. jenomze v pripade nesekvencni varianty, zatimco jeden proces ceka na vyrizeni I/O, dalsi muze vyuzivat procesor. jeste bych mel dodat, ze aby to fungovalo (mimo amdahluv zakon) je potreba, aby pocet procesu byl vetsi nez procesoru.
Pořád to v tom nevidím.pointa je v tom, ze I/O se zacne chovat jako dalsi procesor. vezmi si jako trivialni pripad treba jednoprocesorovy stroj s dvema vlaknama, kdy se musi stridave cist a zpracovavat data... zatimco jedno vlakno cte data (nepotrebuje procesor), druhe pracuje... takze uloha skaluje i kdyz by vlastne nemela.
Což takhle ukázka, do kostry pthreads aplikace napasovat nejskou simulaci výpočtu a IO a počítadlo iterací... půl hodinky. Nebo alespoň odkaz na něco, co takhle krásně škáluje.zkus si to naprogramovat sam, hint jsem dal vys. ja uz jsem touto diskuzi zabil vic casu nez je zdravo. a taky diskuzi o tom, ze ten a ten priklad neni optimalni nebo ze neodpovida realite jsem si uzil uz vic nez dost.
 28.10.2009 19:26
default | skóre: 22
| Madrid
28.10.2009 16:33
Grunt | skóre: 23
| blog: Expresivní zabručení
| Lanžhot
 29.10.2009 01:17
vlk | skóre: 23
| blog: u_vlka
pdflush), mohou běžet na volných procesorech, takže nejen že neubírají procesorový část uživateslkým procesům, ale ješte se ušetří režie přepínání úloh na procesoru (uložení a načtení všech registrů, prohozeni TSS+LDT a pod.).
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz
