Dnes startuje desátý ročník oblíbené kyberbezpečnostní soutěže The Catch organizované Forenzní laboratoří CESNETu. Letos zavede soutěžící do světa národních výzkumných a vzdělávacích sítí (NREN). Čekají na vás tematické úlohy založené na principu Capture the Flag (CTF), hledání ukrytých flagů i zajímavé ceny. Otestujte své schopnosti a vyrazte na lov flagů.
Byly zpracovány a na YouTube zveřejněny videozáznamy z konference LinuxDays 2026.
Německý startup Aleph Alpha k příležitosti výročí sjednocení Německa zveřejnil open-weight jazykový model Kolibri, vyvíjený s ohledem na unijní pojetí autorského práva, ochranu osobních údajů GDPR a nařízení EU o umělé inteligenci, jehož 'Kodexu správné praxe' je Aleph Alpha signatářem. Výsledkem tohoto přístupu je transparentnější technologie, kterou například budou moci využívat evropské veřejné instituce, ovšem za cenu
… více »Nvidia zveřejnila návrh nové bezpečnostní platformy pro nasazování AI agentů. Jedná se o nasazení AI za použití OpenShell a Sentry, dvou oddělených bezpečnostních vrstev, v nichž může Sentry monitorovat a vyhodnocovat chování AI v OpenShellu tak, že ho v krajním případě až vypne. Mělo by to zabránit dalším únikům AI ze sandboxu.
Přímý přenos (YouTube) z konference LinuxDays 2026, jež probíhá tento víkend v Praze v prostorách FIT ČVUT. Na programu je spousta zajímavých přednášek.
Byla vydána nová verze 0.17.0 programovacího jazyka Zig (Codeberg, Wikipedie). Přispělo 206 vývojářů. Přehled novinek v poznámkách k vydání.
Open-source projekt OpenDLSS-NR je 'bitově přesná reimplementace' neuronové rendrovací sítě DLSS 5 od společnosti NVIDIA, jenže pro grafické API Vulkan (DLSS slouží k vylepšování klasickým způsobem vyrendrovaných snímků pomocí lokálních modelů umělé inteligence, a to v reálném čase). Projekt není nijak spojen se společností NVIDIA, je pouze pro OS Windows a natrénované váhy modelu si uživatelé musí obstarat sami. Zdrojový kód je k dispozici na GitHubu, pod licencí MIT s výjimkou pro komponenty třetích stran.
Společnost Cloudflare představila Clef a Clef-Flash, open-source rozhodovací modely určené pro rychlou a konzistentní klasifikaci vstupů. Na rozdíl od klasických LLM vracejí tyto modely deterministické striktně typované strukturované odpovědi s exaktními pravděpodobnostmi, tedy odpovědi ve stylu přelomového modelu Jev.
… více »Byla vydána beta verze Ubuntu 26.10 s kódovým názvem Stonking Stingray. Přehled novinek v poznámkách k vydání. Dle plánu by Ubuntu 26.10 mělo vyjít 15. října 2026.
Byla vydána verze 1.99.0 programovacího jazyka Rust (Wikipedie). Podrobnosti v poznámkách k vydání. Vyzkoušet Rust lze například na stránce Rust by Example.

9.6.2010 17:27
| Přečteno: 5878×
| Za vším hledej Linux
| 
Taky vás tak prudí, kolik místa zabírají DVD s filmy stažená na disk? Mě děsně. Protože však nemám dost času ani na to abych je vůbec stíhal zkouknout, natož zkonvertovat do únosnějšího objemu, píšu si na to skriptík, se kterým by šlo pracovat dávkově.
Na rozdíl od mých poloslepých žen preferuji u filmu originální znění s titulky, proto by měl skript produkovat dual avi + soubor s titulky a fungovat po spuštění pokud možno bez nějaké další asistence. Proto jsem potřeboval nějakou OCR utilitu, co by produkovala alespoň částečně použitelný výsledek.
Před nějakým časem jsem zkoušel extrahovat titulky pomocí dvdsub i pgm2srt, ale s výsledkem jsem moc spokojen nebyl. Druhý zmíněný na tom byl sice přeci jen o něco lépe než ten první, co používá jako backend gocr ale pořád nic moc. Proto jsem se kouknul v Synapticu co v oblasti OCR Debian aktuálně nabízí.
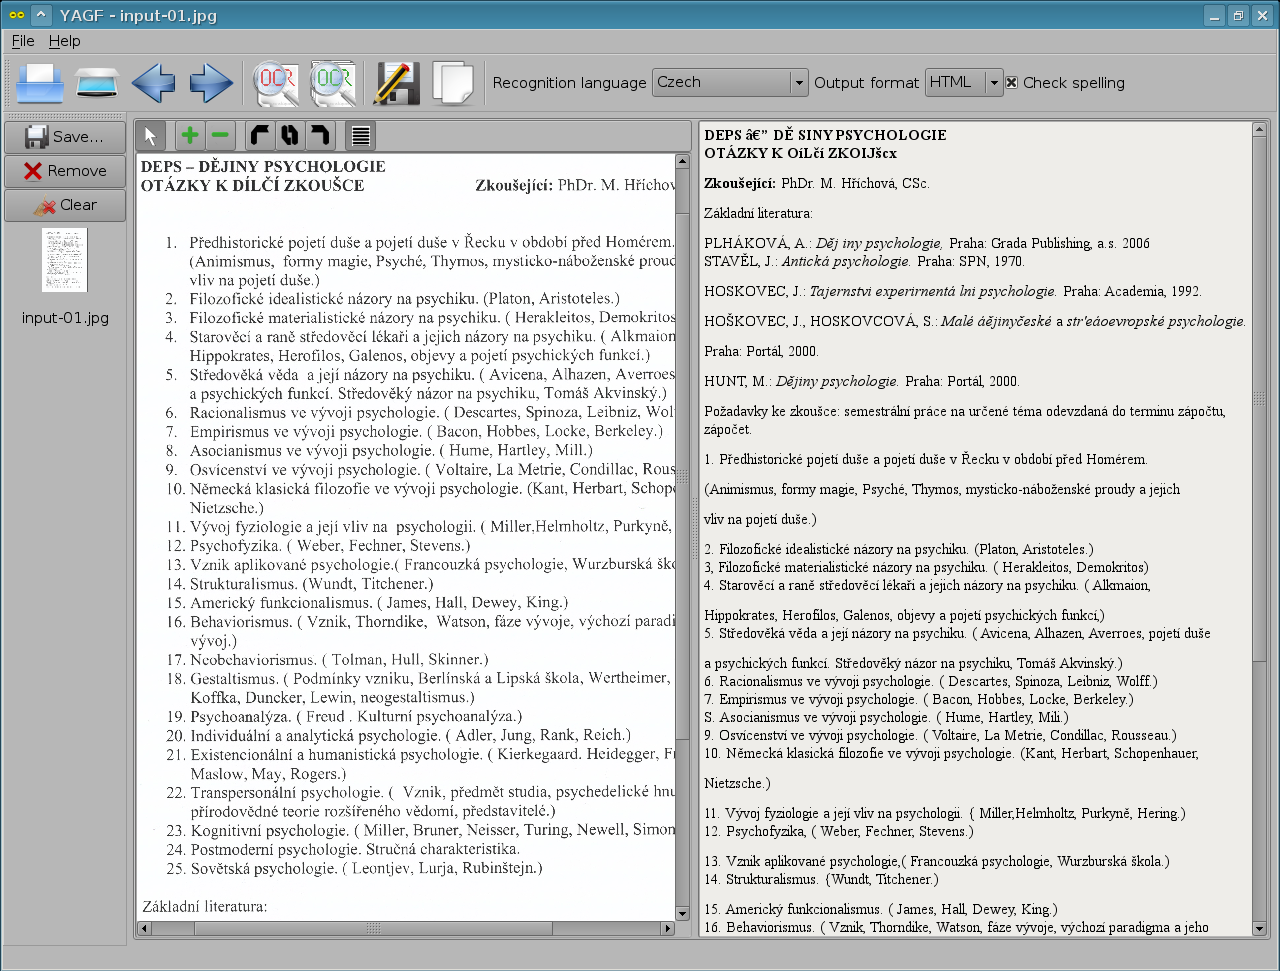
Název aplikace cuneiform mi nic moc neříkal, tak jsem ji vyzkoušel jako první. Předhodil jsem jí jeden starý sken stránky ze samizdatového časopisu, co se mi zrovna válel v domovském adresáři a nestačil se divit. Ve výsledném textu byly pouze dvě problémové věci. Nejčastější chybou byla záměna "í" (většinou za písmeno "f") a špatně byly rozpoznané pouze dvě slova, které byly v kurzívě. Podotýkám předem, že kvalita skenu byla spíš lepší než horší, ale na rozdíl od ostatních cuneiform nezmátla grafika na stránce.
Tesseract jsem zkoušel již dřív, a jelikož nemá podporu pro češtinu, tak jsem jej vynechal rovnou. Výsledek který vyprodukoval gocr a ocrad - škoda slov. Takže jednoznačným favoritem pro můj skript se stal cuneiform. O této aplikaci zde zatím jak se zdá zmínka nepadla, tak proto tento zápis.
Tiskni
Sdílej:


 9.6.2010 17:35
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň

a zrovna sem se ho chystal dneska vyzkouset, zeby nahoda? 
9.6.2010 17:40
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň
nevim jestli je to koser, linkovat ke konkurenciNení! Smrt Rootu!
 -- Ne, co se dá dělat, když to nevyšlo u nás? Od toho existuje HTML, že jo... Ale ty linky pro příště prosím pojmenuj jinak než "tady" - z toho nejde (bez bližšího zkoumání) poznat, kam to vede.
9.6.2010 17:53
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň
9.6.2010 20:26
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň
 9.6.2010 18:36
Amarok | skóre: 33
| blog: blogoblog
9.6.2010 18:46
Amarok | skóre: 33
| blog: blogoblog
9.6.2010 20:26
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň
tam taky bez znalosti azbuky clovek z tech for nic nevycte.
9.6.2010 22:23
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň
Program super, ale nejak nechapu, co ma spolecneho OCR s tim, ze pri grabovani DVD se ma ulozit
soubor s titulky?
a to to jako skenujes z ceho ty titulky? je mas nekde vytisteny na papire?
 9.6.2010 19:14
Limoto | skóre: 32
| blog: Limotův blog
 9.6.2010 19:09
stativ | skóre: 54
| blog: SlaNé roury
Avidemux má cli rozhranie, ale neviem ako je použiteľné a pri OCR ako som písal je potrebná interakcia.
Avidemux má cli rozhranie, ale neviem ako je použiteľné a pri OCR ako som písal je potrebná interakcia.Také používám avidemux, ale už jen na úpravu hotového videa. Pokud jde o to OCR - to je právě výhoda cuneiform - není nutná interakce a výsledek je natolik kvalitní, že stačí zkontrolovat výsledek přes aspell (opět na konzoli). Avidemux pro OCR nejspíš využívá (podobně jako to dělal
pgm2srt) toho že se u titulků zase tak moc šumu neobjevuje, takže lze vzorky porovnávat poměrně jednoduše. Kdežto OCR engine který používá cuneiform má (pravděpodobně) zabudovanou i nějakou další logiku. Proto je výsledek dobrý i bez interakce.
tj. najde shluk pixelů (ideálně je to 1 znak) a zeptá se uživatele, co to je a příště (v rámci jednoho spuštění) už přiřadí znak automaticky. Naprogramoval jsem to speciálně pro převod DVD titulků do TXT, rozhodně je to na nic pokud jde o skenovaný text. GUI má pak i funkce pro úpravu časování titulků, pročištění a převod mezi SUB a SRT.
.
10.6.2010 13:18
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň
takze byste o tom meli minimalne uvazovat
10.6.2010 13:25
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň
11.6.2010 10:45
Amarok | skóre: 33
| blog: blogoblog
11.6.2010 13:30
kotyz | skóre: 25
| blog: kotyzblog
| Plzeň
 AbcLinuxu.cz
 ITBiz.cz
 HDmag.cz
 AbcPráce.cz